

5. Modellen är en funktion
När ni tränade en modell att känna igen olika föremål i Teachable Machine förändrades modellen. Vad är det egentligen som händer när en modell tränas?
Svaret är enklare än det låter: det är inte själva tekniken som förändras, utan de tal som modellen räknar med. En modell består av tal, och träning innebär att talen justeras.
För att se hur det går till lånar vi några verktyg från matematiken: funktioner, räta linjer och regression. Målet är inte avancerade beräkningar, utan att lösa ett enkelt problem och se hur en modell tränas i liten skala.
Hur lång tid tar det att cykla hem?
Sex elever har mätt hur lång tid det tar för dem att cykla hem från skolan:
| Sträcka (km) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Tid (min) | 6 | 10 | 13 | 18 | 21 | 27 |
Konstruerade värden.
En ny elev bor 4,5 km bort. Hur lång tid tar det för hen att cykla hem? Ingen har cyklat exakt den sträckan, så svaret går inte att slå upp. Vi behöver en modell som kan förutsäga tiden för sträckor som saknas i datan.
Varje punkt är en elev. Vilken form verkar punkterna följa?
Funktioner som modell
En funktion tar emot ett värde och lämnar ett annat. Det gör den till ett sätt att beskriva ett system: är indata, är utdata och funktionen är bearbetningen däremellan.
- Indata
Ett värde x som skickas in.
- Bearbetning
Funktionen räknar fram ett nytt värde.
- Utdata
Värdet y som funktionen lämnar.
En funktion tar emot indata, bearbetar den och lämnar utdata. Samma beskrivning passar många olika system.
För cyklarna är sträckan indata och tiden utdata. Modellen vi söker är alltså en funktion som räknar om en sträcka till en tid. Punkterna i diagrammet ligger ungefär längs en rät linje, så vi väljer modellen
En rät linje skrivs . Talet anger hur brant linjen lutar och talet var den skär -axeln.
Nu återstår att bestämma och . Talen i en modell som bestäms utifrån data kallas modellens parametrar. Vår modell har två parametrar.
Människan har valt vilken sorts funktion modellen ska vara, i det här fallet en rät linje. Värdena på parametrarna ska däremot bestämmas utifrån datan. Det är den delen som kallas träning.
Hur bra är modellen?
Vi börjar med en gissning. Anta att det tar 2 minuter per kilometer, plus 8 minuter för att låsa upp cykeln och komma iväg. Som linje blir det och . Bläddra igenom stegen för att se hur gissningen passar datan.
Datapunkterna: sex elevers sträcka och tid hem.
Modellens fel för en elev är skillnaden mellan den verkliga tiden och den tid modellen gissar:
| Sträcka (km) | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Verklig tid (min) | 6 | 10 | 13 | 18 | 21 | 27 |
| Gissning, | 10 | 12 | 14 | 16 | 18 | 20 |
| Fel | −4 | −2 | −1 | +2 | +3 | +7 |
För att få ett enda mått på hur bra modellen är räknar vi medelvärdet av felens storlek, utan att bry oss om plus eller minus. Det kallas medelfel.
Titta också på felen i tabellen. För de korta sträckorna gissar modellen för lång tid, och för de långa sträckorna för kort. Linjen lutar alltså för lite. Felen visar inte bara att modellen missar, utan också hur den behöver ändras.
De streckade linjerna visar felet för varje punkt. Ändra k och m och se hur medelfelet förändras.
Använd reglagen och försök få medelfelet under 1 minut. Skriv ned de värden på och du hittade. Jämför med en klasskamrat: hittade ni samma linje? Vad hände med medelfelet när du bara ändrade ?
Träning är att justera parametrarna
När du drog i reglagen gjorde du samma sak som en dator gör när den tränar en modell: du ändrade parametrarna lite, kontrollerade felet och ändrade igen. Datorn gör likadant, men den räknar ut åt vilket håll varje parameter ska ändras och upprepar stegen tusentals gånger på en bråkdel av en sekund.
För cykeldatan hamnar en bra modell ungefär vid
med ett medelfel på ungefär en halv minut. Nu kan vi svara på frågan från början: den nya eleven, som bor 4,5 km bort, behöver ungefär minuter för att cykla hem.
- Gissa
Välj startvärden på parametrarna, exempelvis k = 2 och m = 8.
- Kontrollera
Mät felet mot träningsdatan.
- Ändra
Justera parametrarna lite i den riktning som minskar felet.
- Upprepa
Kontrollera igen och fortsätt tills felet slutar minska.
Stegen upprepas tills felet inte längre blir mindre. De parametrar som gav minst fel blir den tränade modellen.
Regression: att förutsäga ett tal
När en modell förutsäger ett tal kallas metoden regression. Att använda modellen på ny indata kallas prediktion. Cykelmodellen är en regression med en indata, sträckan, och en utdata, tiden.
| Indata | Utdata |
|---|---|
| Sträcka hem | Cykeltid i minuter |
| Tidigare mätningar av väder | Morgondagens temperatur |
| Utetemperatur och tid på dygnet | Elförbrukning i ett område |
| Bostadens storlek, läge och skick | Försäljningspris |
| Vald väg, trafik och tid på dygnet | Restid i en kartapp |
Modellen i Teachable Machine gjorde något annat. Den valde en kategori, till exempel penna eller suddgummi, och gjorde alltså en klassificering.
| Regression | Klassificering | |
|---|---|---|
| Utdata | Ett tal | En kategori |
| Exempel | Cykeltid i minuter | Penna eller suddgummi |
| Fel mäts som | Avståndet till det verkliga värdet | Om kategorin blev rätt |
Båda är exempel på övervakad inlärning: träningsdatan innehåller det rätta svaret, här den verkliga cykeltiden.
Begränsningar hos regression
En modell är ett verktyg. Den kan vara mycket användbar, men bara om man vet när den går att lita på.
Modellen gäller där datan finns
Vad förutsäger cykelmodellen för en sträcka på 40 km?
Svaret går att räkna ut, men det är inte säkert att det stämmer. Ingen i träningsdatan cyklade längre än 6 km. På en lång sträcka blir man trött, tar pauser och cyklar kanske på helt andra vägar. Modellen har aldrig sett sådana exempel.
Den heldragna linjen bygger på data. Den streckade delen är en gissning långt utanför datan. Den prickade kurvan är ett tänkt exempel på hur trötthet och pauser kan göra verkligheten annorlunda.
Att använda en modell utanför det område där den har data kallas extrapolering. Samma problem uppstår när en modell som har tränats på sommarens elförbrukning ska förutsäga förbrukningen en kall vinterdag. En modell fungerar bäst på indata som liknar träningsdatan, och förmågan att fungera på nya exempel, generaliseringen, har gränser.
Modellen blir aldrig bättre än datan
Modellen lär sig bara det som finns i datan. Tänk dig att alla sex eleverna hade varit tävlingscyklister. Modellen skulle då passa sin egen data bra, men förutsäga alldeles för korta tider för en vanlig elev. Inget i modellen avslöjar det.
Modellen tränas bara på tävlingscyklister och passar dem bra. Medelfel: 0,1 min
Samma sak händer om datan innehåller fel. Tänk dig att någon glömde att stoppa tidtagningen och rapporterade 35 minuter för 3 km. En enda felaktig punkt räcker för att dra linjen åt fel håll.
Modellen tränad på korrekta mätningar. Medelfel: 0,5 min
Inom programmering finns ett gammalt uttryck för det här: garbage in, garbage out, eller på svenska skit in, skit ut. Ett system som får dålig indata ger dåliga resultat, hur avancerat det än är.
Därför är datakvalitet och val av data lika viktiga som själva modellen. Du såg samma sak i Teachable Machine, där modellen kunde lära sig bakgrunden i stället för föremålet.
Formen måste passa verkligheten
Vi valde en rät linje eftersom punkterna såg ut att ligga längs en. Många samband ser inte ut så. En krukväxt växer snabbt i början och sedan allt långsammare. Antalet resenärer på en buss har toppar på morgonen och på eftermiddagen. För sådana samband behövs modeller som kan böja sig, men principen är densamma: välj en form, mät felet och justera parametrarna.
Det går också att göra fel åt andra hållet. En kurva som är så böjlig att den går genom varje punkt passar träningsdatan perfekt, men den följer då slumpen i mätningarna i stället för det verkliga sambandet. För nya mätningar blir förutsägelserna sämre. Det kallas överanpassning.
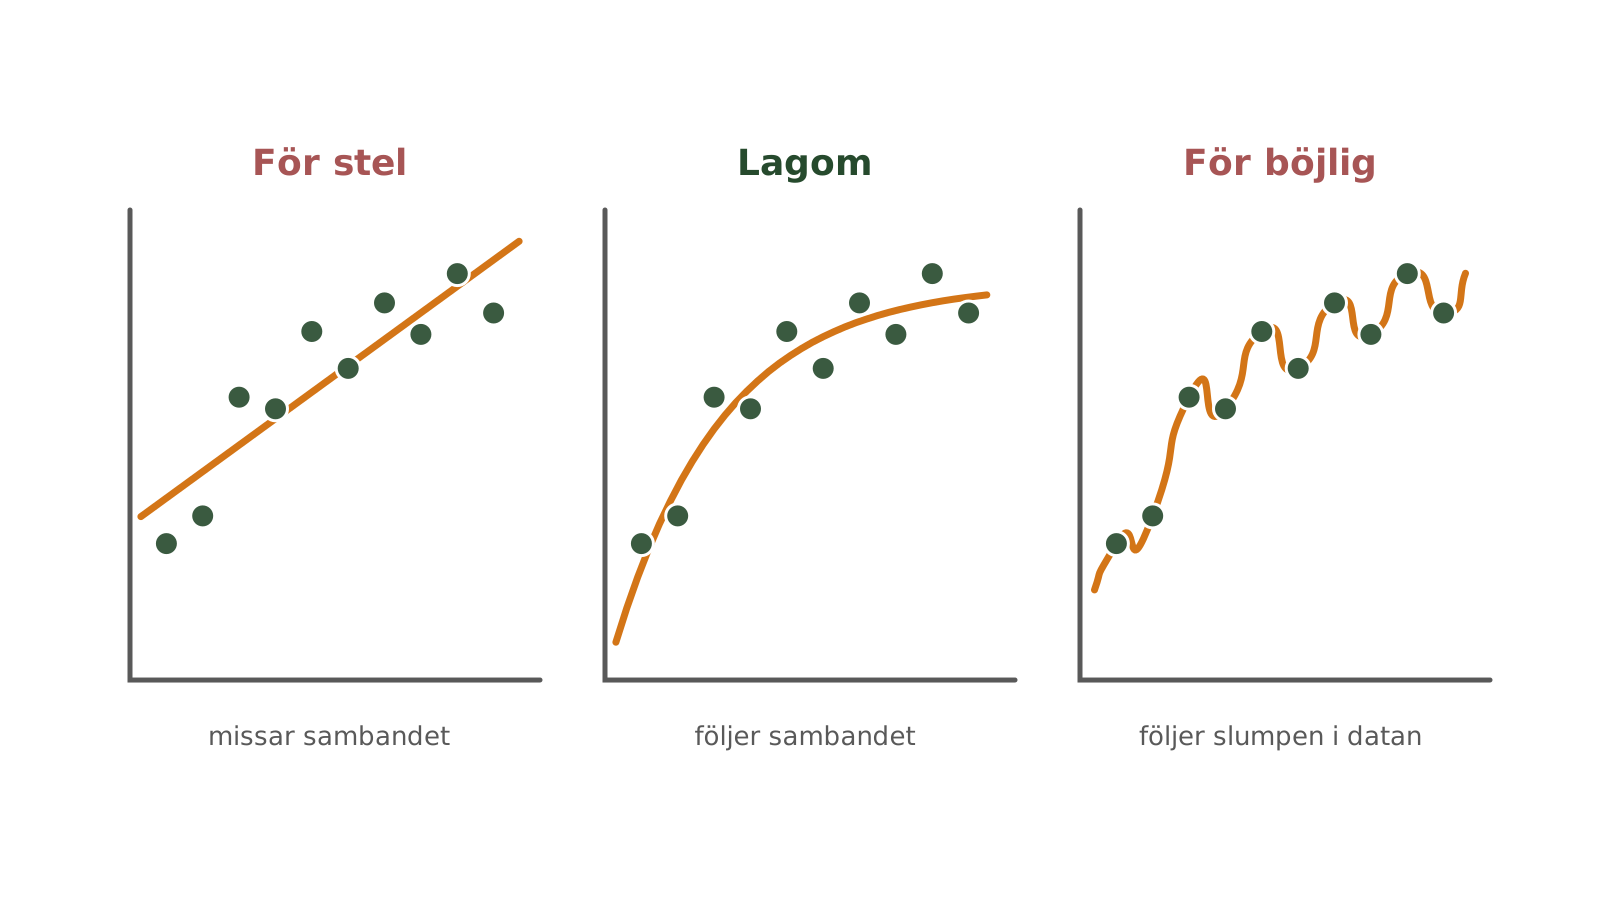
Samma data med tre modeller. Bara den mittersta går att lita på för nya mätningar.
Ett samband är inte en orsak
Under sommaren säljs det mer glass, och det sker också fler drunkningsolyckor. Kurvorna följer varandra nästan perfekt.
Konstruerade värden som visar ett typiskt årsmönster.
En regressionsmodell skulle kunna förutsäga antalet drunkningsolyckor ganska bra utifrån glassförsäljningen. Det betyder inte att glass orsakar drunkning. Båda beror på något tredje: varmt väder, då fler både äter glass och badar.
En modell hittar samband i data, men den kan inte avgöra vad som orsakar vad. Att förbjuda glass skulle inte minska antalet drunkningsolyckor.
På webbplatsen Spurious Correlations har Tyler Vigen samlat hundratals dataserier som följer varandra nästan perfekt utan att ha något med varandra att göra. Hitta ditt favoritexempel och försök förklara varför sambandet inte kan vara en orsak.
Parametrarna går att tolka, ibland
I cykelmodellen betyder parametrarna något i verkligheten. innebär att varje extra kilometer tar ungefär 4 minuter, vilket motsvarar 15 km/h. är tid som inte beror på sträckan, till exempel att låsa upp cykeln.
Stora AI-modeller har miljontals eller miljarder parametrar, och de tränas i serverhallar fulla av datorer.
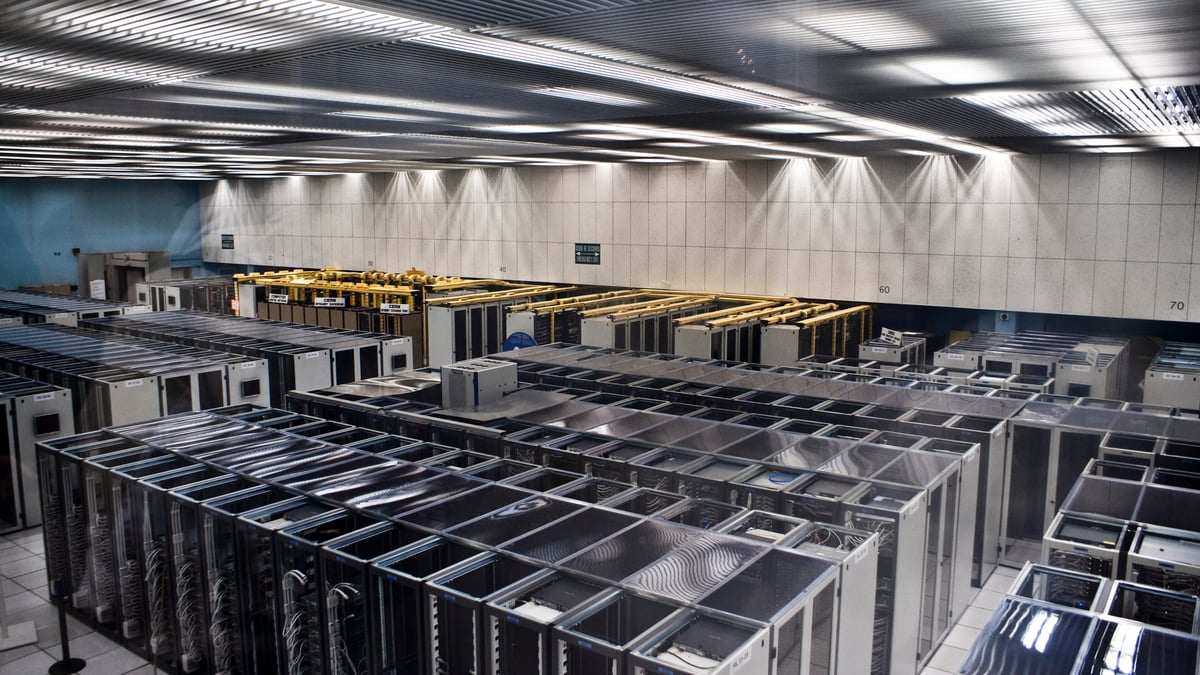
Serverhallen vid forskningscentret CERN i Schweiz.
I en så stor modell betyder inget enskilt tal något som en människa kan förstå, och det går därför inte att läsa ut varför modellen gav ett visst svar. Förmågan att förklara hur ett system kommer fram till sina resultat kallas transparens. Den blir särskilt viktig när en modell används för beslut som påverkar människor, till exempel vem som ska få ett lån.
Exempel och tillämpningar
Väderprognoser
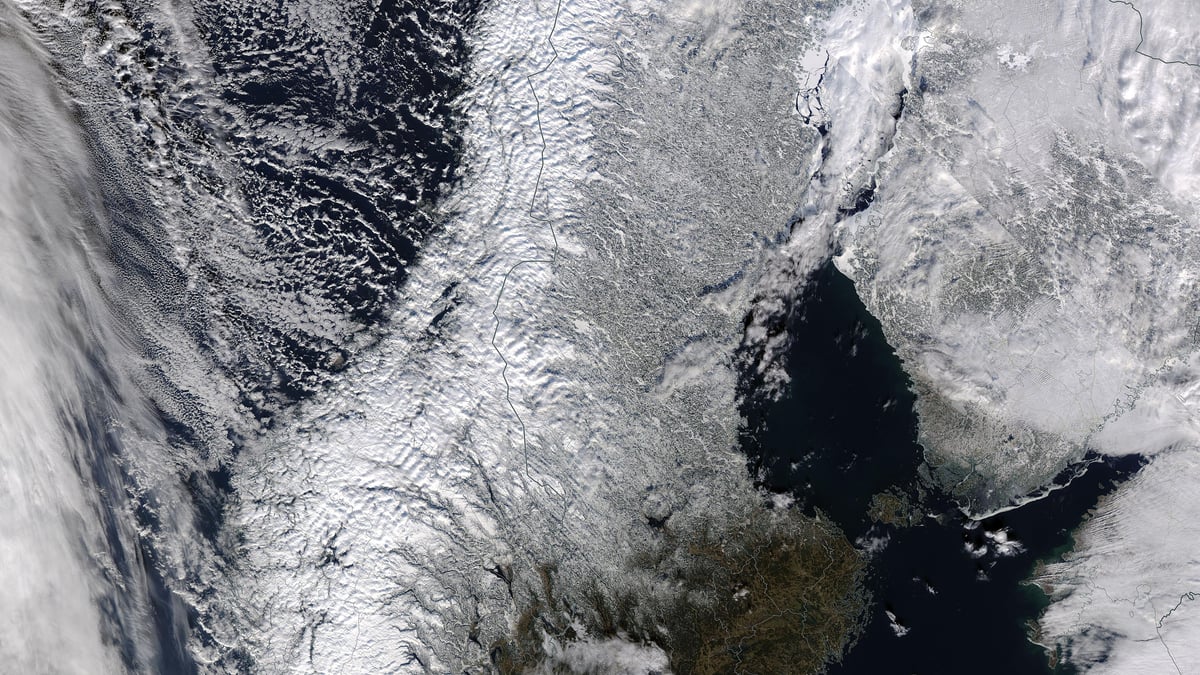
Skandinavien fotograferat av NASA:s satellit Terra den 27 februari 2021.
En väderprognos förutsäger tal: temperatur, nederbörd och vindstyrka för de kommande dagarna. Indata är mätningar från väderstationer, satelliter, flygplan och väderballonger. Principen känns igen från cykelmodellen: modellen tar emot data och lämnar ett förutsagt tal, och förutsägelserna jämförs hela tiden med hur vädret faktiskt blev.
De flesta väderprognoser bygger i grunden på en simulering. Atmosfären delas in i ett rutnät, och fysikens lagar för hur luft, värme och fukt rör sig används för att räkna fram vädret steg för steg in i framtiden. En simulering är alltså regelstyrd: reglerna är naturlagar som människor har formulerat.
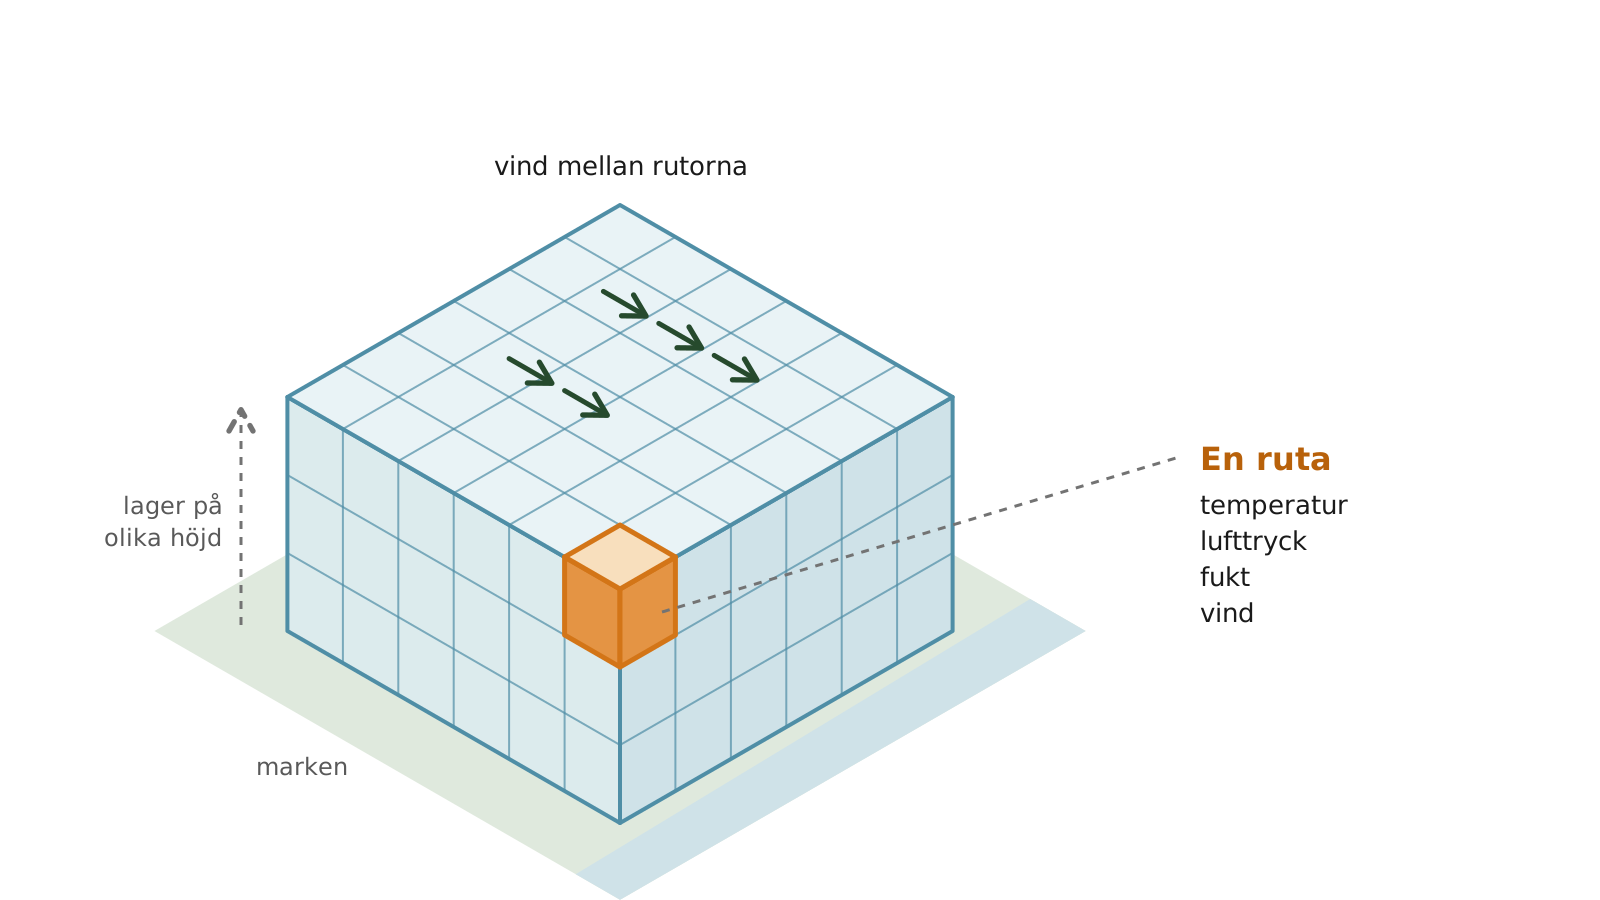
Varje ruta påverkar sina grannar. Simuleringen räknar ut hur, ett tidssteg i taget.
Simuleringen blir ändå inte perfekt. Därför justeras resultatet ofta med modeller som har tränats på hur tidigare prognoser stämde med det väder som faktiskt blev. Den delen är regression i ordets rätta bemärkelse.
Under senare år har det också kommit vädermodeller som tränats direkt på flera decenniers vädermätningar, utan att räkna med fysikens ekvationer. Det europeiska vädercentret ECMWF tog en sådan modell i drift i februari 2025, som ett komplement till den fysikbaserade simuleringen.1 Den tränade modellen kräver ungefär tusen gånger mindre energi per prognos.
Många indata samtidigt
Cykeltiden beror inte bara på sträckan. Backar, trafikljus och vind påverkar också. Verkliga modeller har därför nästan alltid flera indata, och varje indata får då en egen parameter:
Varje indata multipliceras med sin parameter , och resultaten summeras. Parametrarna kallas då ofta vikter, eftersom de bestämmer hur mycket varje indata väger. Träningen fungerar på samma sätt som för cykelmodellen: vikterna justeras tills felet blir så litet som möjligt.
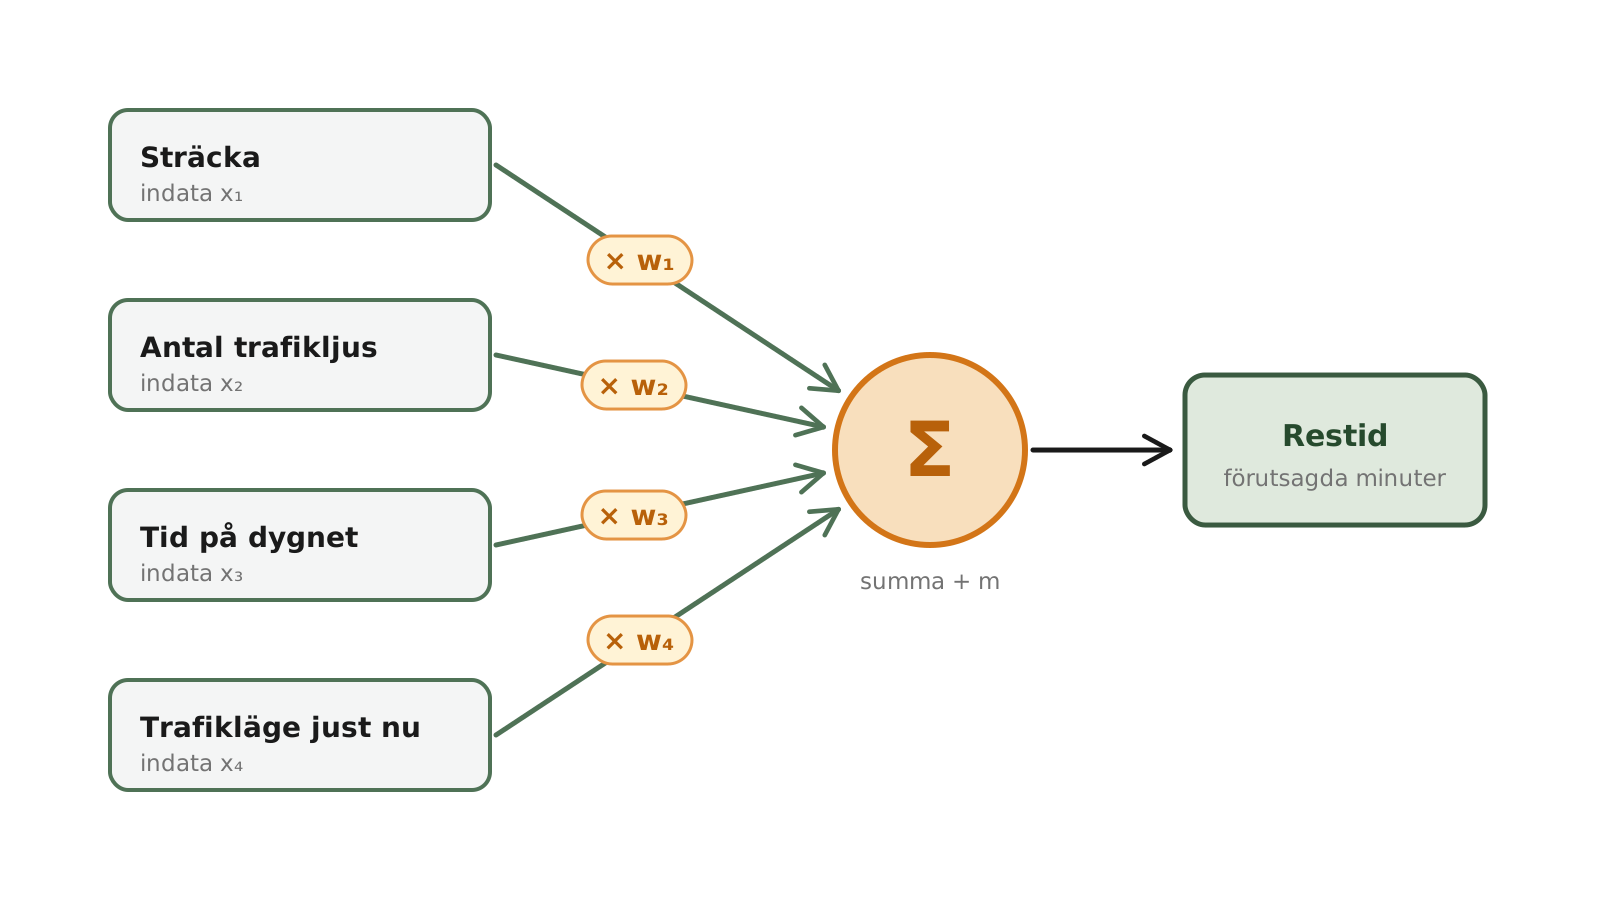
En modell med fyra indata. Varje pil har en egen vikt som bestäms under träningen.
En kartapp som förutsäger restid kan till exempel väga samman sträckan, antalet trafikljus, tiden på dygnet och hur trafiken ser ut just nu. En elleverantör som ska förutsäga morgondagens förbrukning väger samman temperatur, veckodag och förbrukningen samma dag förra året.
Sammanfattning
- En modell som förutsäger ett tal kan vara en funktion, exempelvis den räta linjen .
- Talen i modellen, här och , kallas parametrar.
- Modellens fel är skillnaden mellan verkligt och förutsagt värde. Medelfelet sammanfattar hur bra modellen passar datan.
- Träning innebär att parametrarna justeras stegvis så att felet minskar: ändra, kontrollera, ändra igen.
- Regression förutsäger ett tal, medan klassificering väljer en kategori.
- En modell är mest pålitlig för indata som liknar träningsdatan och blir aldrig bättre än datan den tränats på.
- Formen måste passa sambandet. En för stel modell missar sambandet, en för böjlig överanpassar.
- En modell hittar samband, inte orsaker.
- Små modeller går att tolka. Stora modeller med miljontals parametrar saknar ofta transparens.