

7. Perceptronen
När ni tränade en modell i Teachable Machine visade ni kameran en penna och ett suddgummi, och modellen svarade med en klass. Modellens indata var bilder från kameran. Hur beskrivs en bild med tal, och hur använder modellen dem för att välja en klass?
I uppgiften Förutsäg! arbetade ni direkt med tal: ni ändrade parametrar och såg hur modellens förutsägelser förändrades. Här bygger vi vidare på samma idé för att förstå klassificering. Vi undersöker hur en bild blir tal och hur en perceptron, en enkel modell som väljer mellan två klasser, räknar fram sitt svar och lär sig från märkta exempel.
En bild är tal
En digital bild består av små rutor som kallas pixlar. Varje pixels färg beskrivs med tal. I vårt exempel har bilden bara två färger: vi låter 1 betyda svart och 0 betyda vitt.
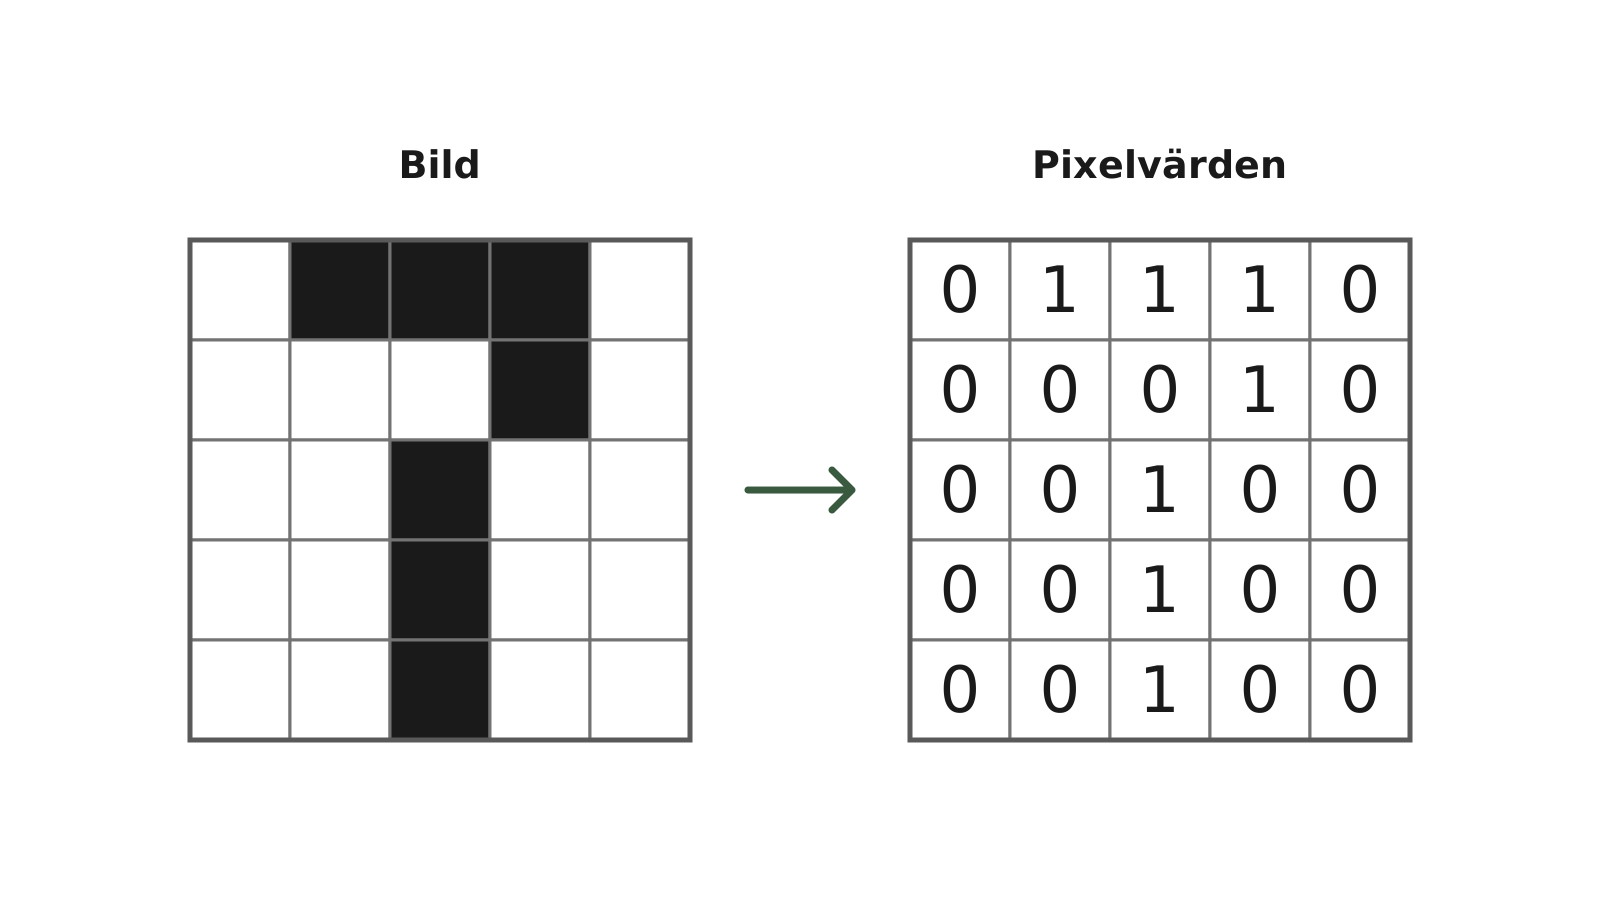
Samma bild på två sätt. Varje svart pixel motsvarar 1 och varje vit pixel 0. Bildens 5 × 5 pixlar blir 25 tal.
I exemplet ovan räckte ett tal per pixel. En färgbild beskrivs vanligtvis med tre tal per pixel: ett för rött, ett för grönt och ett för blått. Tillsammans anger de pixelns färg.
Teachable Machine anpassar kamerabilden till 224 pixlar på bredden och 224 pixlar på höjden. Det betyder att bilden innehåller
Varje pixel beskrivs med tre tal för rött, grönt och blått. Därför innehåller bilden totalt
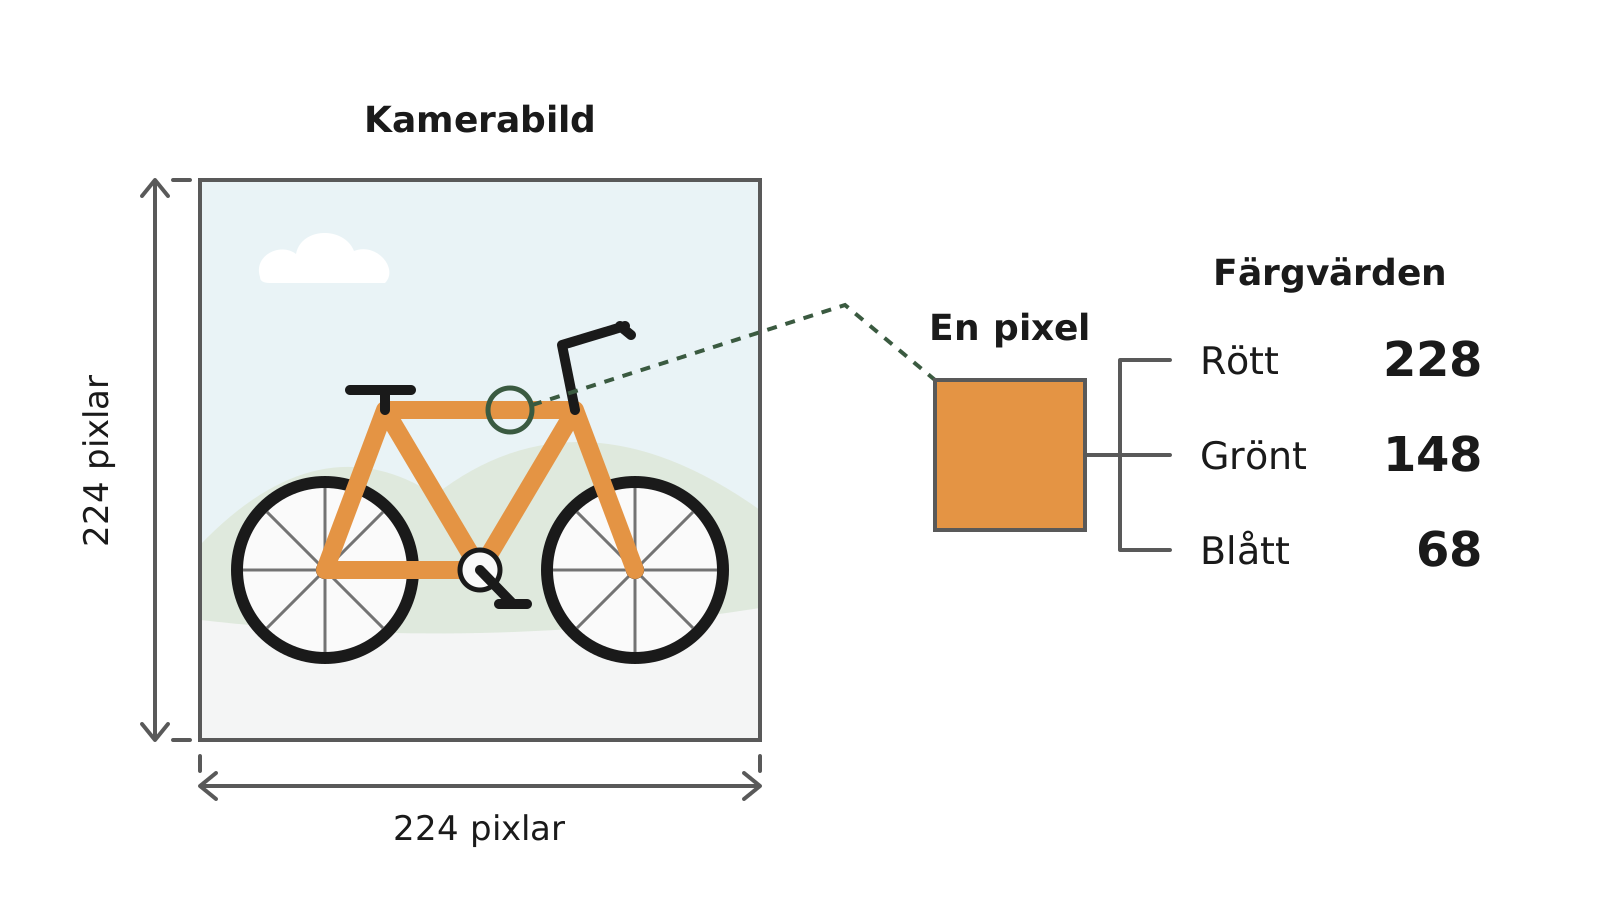
Kamerabilden innehåller 224 · 224 = 50 176 pixlar. Varje pixel beskrivs med tre färgvärden, så hela bilden blir 150 528 tal.
RGB står för red, green och blue, alltså rött, grönt och blått. Färgen skapas genom att blanda ljus i dessa tre färger.
I vårt exempel anges varje färgvärde med ett tal från 0 till 255. 0 betyder inget ljus av den färgen och 255 betyder full styrka. Tre nollor ger svart, medan tre 255:or ger vitt.1
Den orange pixeln på cykelramen har värdena 228, 148 och 68: mycket rött, mindre grönt och ännu mindre blått. Tillsammans beskriver de pixelns orange färg.
För modellen är en bild alltså en lång lista med tal, precis som sträckan var ett tal för cykelmodellen.
Från några få indata till tusentals
I regressionsmodellen med flera indata multiplicerades varje indata med en egen parameter. Dessa parametrar kallas vikter, eftersom de bestämmer hur mycket varje indata påverkar resultatet. När varje indata multipliceras med sin vikt och resultaten summeras får vi en viktad summa.
En vikt är en parameter som multipliceras med en indata innan summan beräknas. I termen är vikten och indatan.
När övriga indata och parametrar är oförändrade gäller:
- Positiv vikt: när indatan ökar blir summan större.
- Negativ vikt: när indatan ökar blir summan mindre.
- Vikten 0: indatan påverkar inte summan.
Vid träning justeras vikternas värden.2
I bostadsmodellen i Förutsäg! var ytan och avståndet till centrum indata:
Ytan fick en positiv vikt : större bostäder fick ett högre förutsagt pris. Avståndet fick en negativ vikt : längre från centrum gav ett lägre förutsagt pris.
Cykelmodellen hade bara en indata, sträckan. En verklig cykelresa påverkas också av backar och vind. Vi lägger därför till höjdmeter uppför, alltså hur många meter vägen sammanlagt stiger, och motvind, mätt i meter per sekund. Varje ny indata får en egen vikt:
Bläddra från en till tre indata och se vad som händer med diagrammet.
Fler indata får fler vikter i cykelmodellen. Två indata och en utdata kan visas med tre axlar som ett plan. När motvinden läggs till visar varje plan bara en vald motvind. Alla tre indata kan fortfarande användas i beräkningen, även när diagrammet istället jämför uppmätt och förutsagd tid.
Fler indata får fler vikter i modellen. Beräkningen fungerar fortfarande, även när hela sambandet blir svårt att visa i ett enda diagram. Data och vikter är konstruerade för exemplet.
Beräkningen fungerar lika bra med tre indata som med en. Det som blir svårt är att rita modellen, eftersom varje indata behöver en egen axel.
Samma princip kan användas för en bild. Varje färgvärde blir en indata med en egen vikt, och kamerabildens 150 528 färgvärden kräver lika många vikter:
Att välja alla dessa vikter för hand går inte i praktiken. Genom träning på märkta exempel kan modellen istället lära sig vilka värden vikterna ska ha.
Det finns också en annan skillnad. Cykelmodellen förutsäger ett tal: summan 18 betyder 18 minuter. Modellen i Teachable Machine skulle istället välja en klass. För en bildmodell har summan ingen sådan betydelse. Den är en poäng som beror på bildens värden och modellens vikter, och vi behöver bestämma var gränsen mellan klasserna går.
I det förenklade exemplet nedan jämför vi två bilder med 3 × 3 pixlar. Svart är 1 och vitt är 0. Varje bild har nio pixlar, så summan har nio termer:
Vikterna är valda för att visa principen och är samma för båda bilderna.
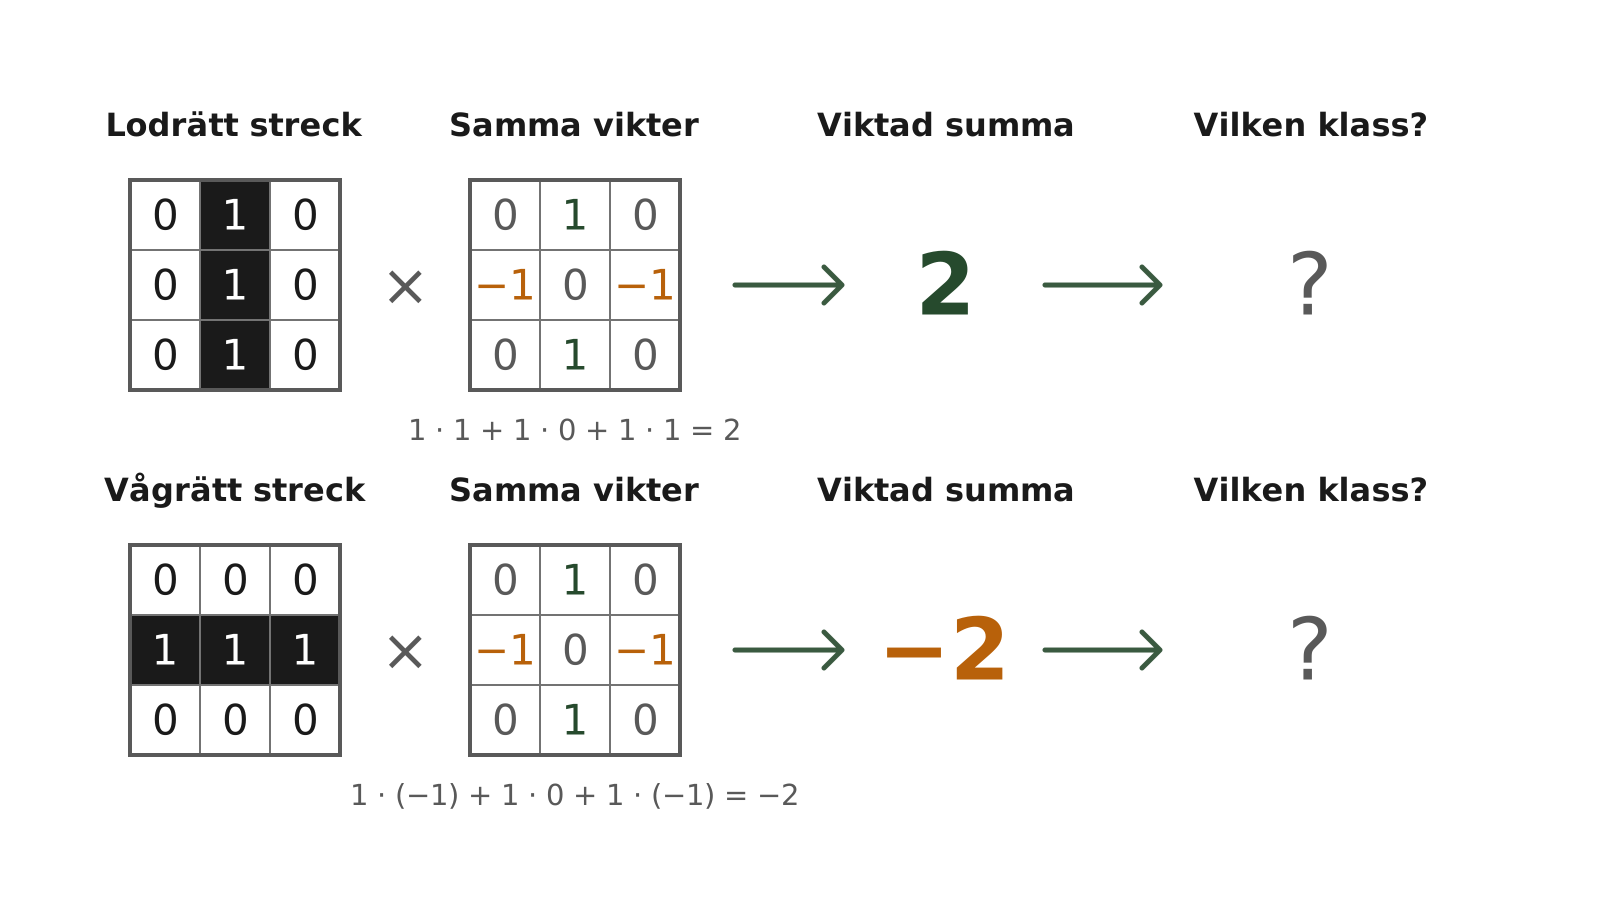
Varje pixelvärde multipliceras med vikten på motsvarande plats, och produkterna summeras. Beräkningarna under rutnäten visar de svarta pixlarnas bidrag; vita pixlar ger 0.
Perceptronen: en summa och en gräns
I exemplet med 3 × 3 pixlar slutade båda beräkningarna med en fråga: vilken klass ska modellen svara? Summorna 2 och −2 är bara tal. Vi behöver en regel som gör om en summa till en klass.
Den enklaste regeln är att jämföra summan med ett tröskelvärde. En modell som gör det kallas perceptron, och den är en av de äldsta idéerna inom maskininlärning. Den utför två steg:
- Den beräknar en viktad summa av sina indata, precis som regressionsmodellen.
- Den jämför summan med tröskelvärdet. Är summan större än tröskelvärdet lämnar den utdata 1, annars 0.
Utdata 1 och 0 motsvarar varsin klass. Steget som gör om summan till 0 eller 1 kallas stegfunktion, eftersom utdata hoppar direkt från 0 till 1 när summan passerar tröskelvärdet. Det finns inget mittemellan: en summa som nästan når tröskelvärdet ger ändå 0.
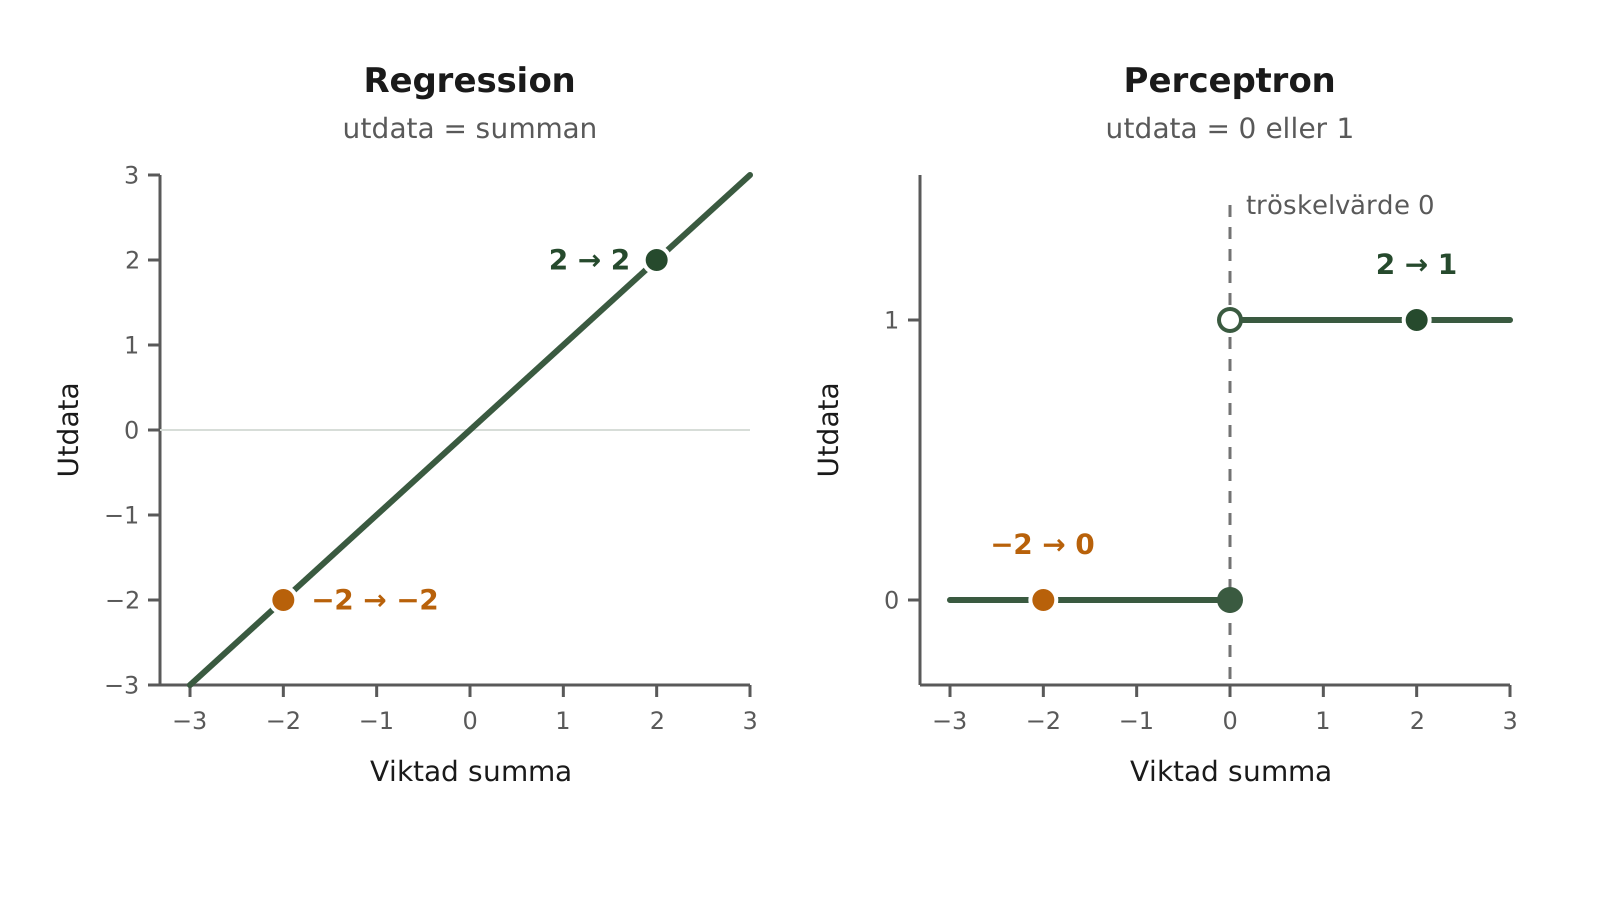
Regressionen lämnar summan som ett tal. Stegfunktionen gör om samma summa till 0 eller 1, och utdata hoppar när summan passerar tröskelvärdet.
Nu kan vi besvara frågan från exemplet med 3 × 3 pixlar: vilken klass ska modellen svara? Låt utdata 1 betyda lodrätt streck och 0 betyda vågrätt streck, och sätt tröskelvärdet till 0:
- Det lodräta strecket ger summan 2. Summan är större än 0, så perceptronen svarar 1: lodrätt streck.
- Det vågräta strecket ger summan −2. Summan är mindre än 0, så perceptronen svarar 0: vågrätt streck.
Tröskelvärdet fyller samma funktion som i regressionen. Det är ett tal som inte hör till någon indata, men som flyttar gränsen för när modellen svarar 1.
Vad betyder vikterna i en bild?
Vikterna tolkas som i bostadsmodellen, men nu handlar det om klasser. En positiv vikt betyder att indatan talar för klass 1, och en negativ vikt att den talar emot. Vikten 0 betyder att indatan inte påverkar svaret.
I exemplet med 3 × 3 pixlar talar en svart pixel ovanför eller under mitten för ett lodrätt streck, eftersom vikten är +1. En svart pixel till vänster eller höger om mitten talar emot, eftersom vikten är −1.
I en kamerabild har varje pixel en egen vikt, och de pixlar som brukar skilja klasserna åt får stora vikter, positiva eller negativa. Men modellen vet inte vilka pixlar som visar föremålet och vilka som visar bakgrunden. Om alla pennor filmades framför en vit vägg och alla suddgummin framför en bokhylla, kan bakgrundens pixlar få de största vikterna. Modellen blir då bra på att skilja väggen från bokhyllan, inte pennan från suddgummit.
Exempel: citron eller apelsin?
Med tusentals pixlar går det inte att följa beräkningen. Därför tittar vi på en perceptron med bara två indata: fruktens bredd och höjd i centimeter. Utdata 1 betyder citron och 0 betyder apelsin.
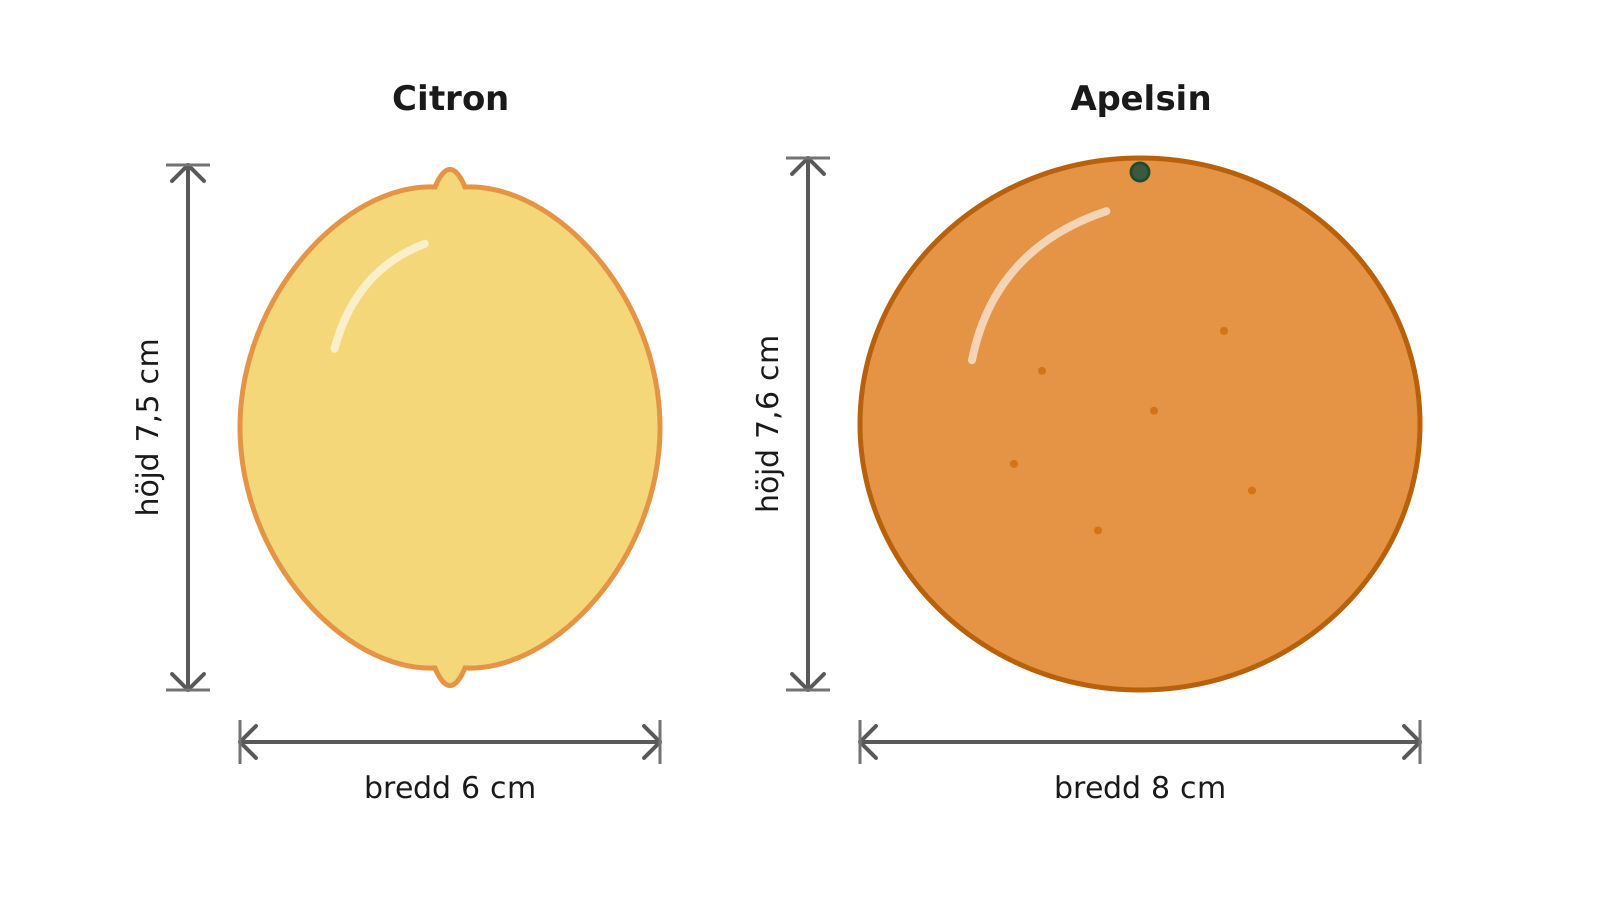
Citronen är högre än den är bred. Apelsinen är ungefär lika bred som hög.
Perceptronen har fått vikten −1 för bredden och +1 för höjden, och tröskelvärdet 0,5:
- Citronen: . Summan är större än 0,5, så perceptronen svarar citron.
- Apelsinen: . Summan är mindre än 0,5, så perceptronen svarar apelsin.
Vikterna betyder ungefär: om frukten är mer än en halv centimeter högre än den är bred, är det en citron.
Perceptronen drar en linje
Perceptronen byter svar exakt där summan är lika med tröskelvärdet:
Det är en rät linje med och . Alla frukter ovanför linjen blir citroner och alla under blir apelsiner. Linjen kallas perceptronens beslutsgräns.
Med två indata är beslutsgränsen alltid en rät linje. Att träna perceptronen innebär alltså att hitta en linje som delar upp träningsdatan i rätt klasser.
I regressionen var linjens och modellens parametrar. Här bestäms de av perceptronens parametrar: vikterna och tröskelvärdet. När du ändrar och i diagrammet nedan motsvarar det alltså att ändra vikterna och tröskelvärdet.
Över linjen: citron. Under linjen: apelsin.
Konstruerade mätvärden. Startlinjen säger att alla höga frukter är citroner, vilket ger fyra rätt av tio. En vågrät linje tar bara hänsyn till höjden, och det räcker inte: den högsta apelsinen är högre än alla citronerna. Ändra k och m tills alla frukter hamnar på rätt sida.
I regressionen skulle linjen ligga så nära punkterna som möjligt. Här ska linjen istället ligga mellan två grupper av punkter. Beräkningen är densamma, men uppgiften är en annan: regression förutsäger ett tal, perceptronen klassificerar.
Med en bild som indata finns det lika många axlar som indata, och gränsen går inte att rita. Principen är ändå densamma: vikterna och tröskelvärdet bestämmer var gränsen mellan klasserna går.
Hur lär sig perceptronen?
Vikterna i fruktexemplet valde vi själva. Poängen med en perceptron är att den kan hitta dem på egen hand, från märkta exempel. År 1957 presenterade psykologen Frank Rosenblatt en inlärningsregel som gör just det.3 När perceptronen svarar rätt på ett exempel ändras ingenting. När den svarar fel justeras vikterna så att summan för exemplet hamnar närmare rätt sida om tröskelvärdet. I fruktdiagrammet betyder det att beslutsgränsen flyttas en bit, så att frukten som hamnade fel kommer närmare rätt sida.
Det är samma idé som när en regressionsmodell tränas: mät felet, justera parametrarna i rätt riktning och upprepa. Skillnaden är att felet här bara kan vara rätt eller fel.
Rosenblatt byggde också en maskin, Mark I-perceptronen, som kunde tränas att känna igen enkla mönster i bilder från en kamera med 20 × 20 ljuskänsliga celler. Varje cell var en indata, och vikterna ställdes in av elektriska motorer. Du såg den i lektionen Vägen till generativ AI.
Perceptronen var inspirerad av nervceller i hjärnan. En nervcell tar emot signaler från många andra nervceller via sina dendriter. Om de sammanlagda signalerna blir tillräckligt starka skickar cellen en egen signal vidare genom sitt axon.

Redan 1943 beskrev Warren McCulloch och Walter Pitts en förenklad, matematisk nervcell som fungerade på liknande sätt: summera signaler och skicka vidare en signal om summan når ett tröskelvärde.4 Perceptronen lade till det viktigaste: ett sätt att lära sig vikterna från exempel.
Likheten med hjärnan är ändå ytlig. En verklig nervcell är en levande cell med kemiska och elektriska processer som är betydligt mer komplicerade än en viktad summa. Namnet artificiell neuron beskriver en inspiration, inte en kopia.
Sammanfattning
- En bild är tal: varje pixel lagras som ett eller flera tal, och varje tal kan vara en indata till en modell.
- En viktad summa multiplicerar varje indata med sin vikt och summerar resultaten. En kamerabild ger en vikt per färgvärde, alldeles för många för att ställa in för hand. Vikterna hittas istället genom träning.
- En perceptron jämför den viktade summan med ett tröskelvärde. Är summan större blir utdata 1, annars 0. Steget som gör om summan till 0 eller 1 kallas stegfunktion. Regression förutsäger ett tal, perceptronen väljer en klass.
- Positiva vikter talar för klass 1, negativa vikter talar emot och vikten 0 påverkar inte svaret. Modellen vet inte vilka pixlar som visar föremålet, så även bakgrunden kan få stora vikter.
- Med två indata är perceptronens beslutsgräns en rät linje. Vikterna och tröskelvärdet bestämmer var linjen går.
- Rosenblatts inlärningsregel justerar vikterna när perceptronen svarar fel, samma princip som att justera parametrarna i en regression.
- Perceptronen var inspirerad av nervceller men är en starkt förenklad modell.
Källor
Footnotes
-
W3C, CSS Color Module Level 4, avsnitt 5.1, ”The RGB functions: rgb() and rgba()”, och 6.1, ”Named Colors”, W3C. ↩
-
Google, Machine Learning Crash Course: Linear regression, särskilt avsnittet ”Models with multiple features”, Google for Developers. ↩
-
Frank Rosenblatt, ”The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain”, Psychological Review, vol. 65, nr 6, 1958, s. 386–408, APA PsycNet. ↩
-
Warren S. McCulloch och Walter Pitts, ”A Logical Calculus of the Ideas Immanent in Nervous Activity”, Bulletin of Mathematical Biophysics, vol. 5, 1943, s. 115–133, Springer. ↩