

1. Text blir tal
Hur tar du reda på något du undrar över? För många har svaret länge varit att googla. Nu får vi allt oftare ett färdigt svar från en AI-tjänst. I den här lektionen undersöker vi vad som finns bakom svaren: hur en språkmodell gör om text till tal och skriver sitt svar, en liten bit i taget.
Från sökträffar till färdiga svar
Fler än nio av tio elever på högstadiet och gymnasiet använder AI, antingen en AI-tjänst som ChatGPT eller Googles AI-översikter.1
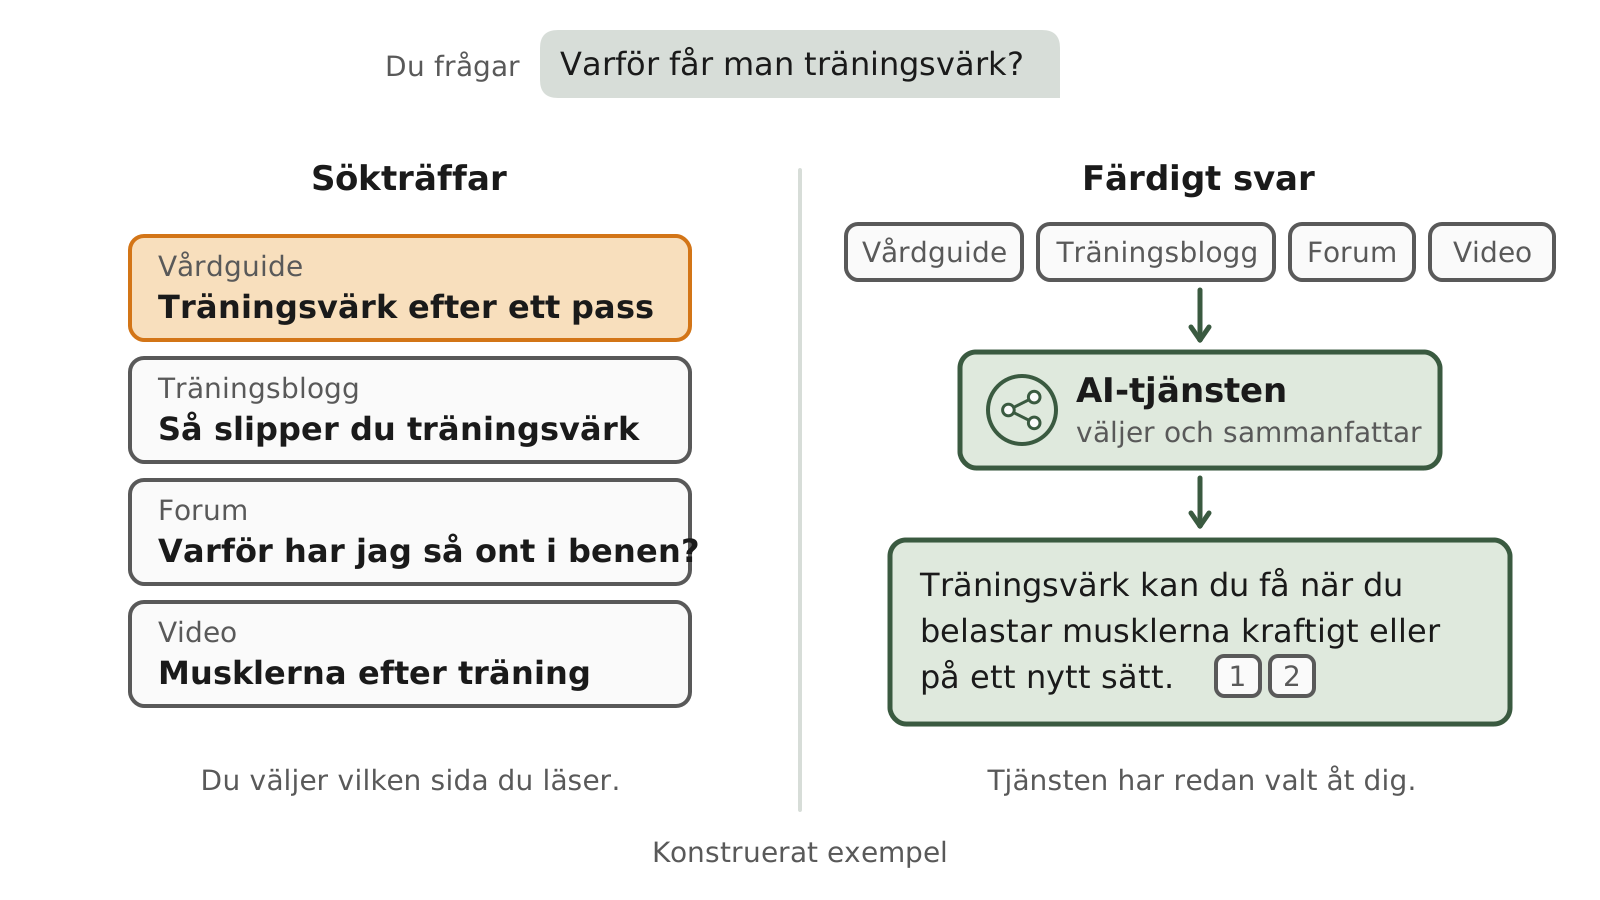
Med sökträffar väljer vi källan. Med ett färdigt svar har tjänsten redan valt.
Med en vanlig sökning får vi en lista med sidor och väljer själva vilken vi läser. En AI-tjänst väljer och sammanfattar åt oss. Det går snabbare, men vi lämnar över en del av urvalet till tjänsten.
Hänvisningarna till källorna finns ofta kvar, och vi kan följa dem. Själva svaret har däremot ingen människa skrivit, så vi kan inte granska det som vi granskar en författare. Svaret skrivs av en språkmodell, även när tjänsten först har sökt efter källor. För att kunna granska svaret behöver vi förstå hur en språkmodell skriver.
Pinsam och imponerande
AI-tjänster kan göra bort sig ordentligt. De kan också imponera.
När AI gör bort sig
En chattbot fick frågan hur man dricker ur en kopp som saknar botten och har en försluten topp.
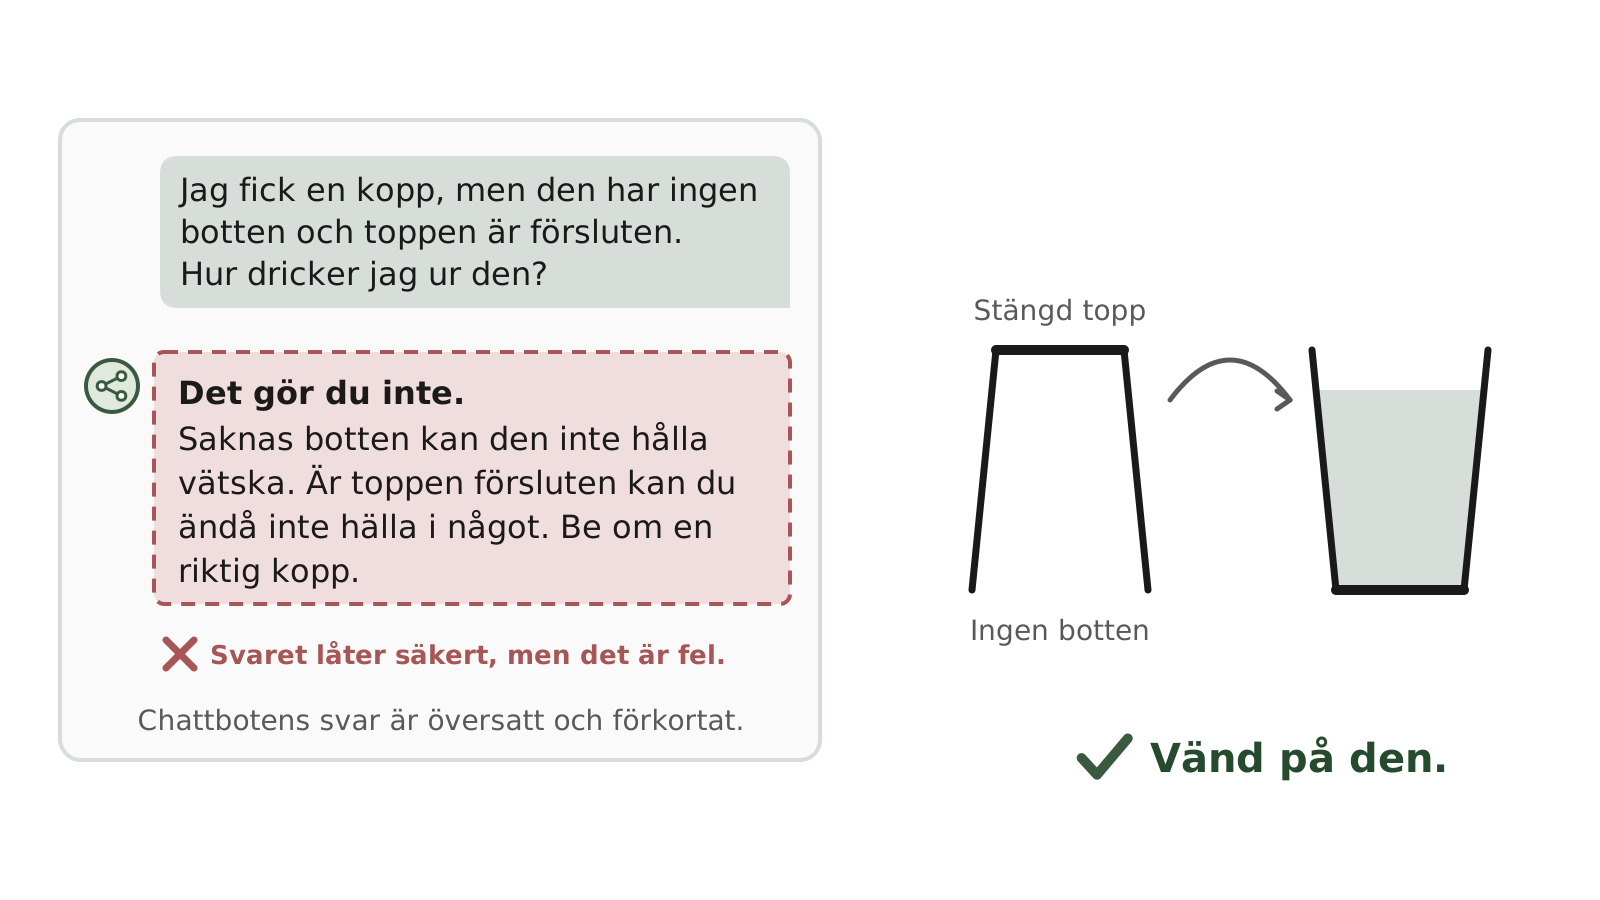
Koppen står bara upp och ner. Chattbotens svar är översatt och förkortat efter en skärmdump från 2026.2
En annan fråga gäller biltvätten: Jag vill tvätta bilen. Biltvätten ligger 50 meter bort. Ska jag gå eller köra? Den som går kommer fram utan bil. I februari 2026 ställde företaget Opper frågan tio gånger till var och en av 53 AI-modeller.3
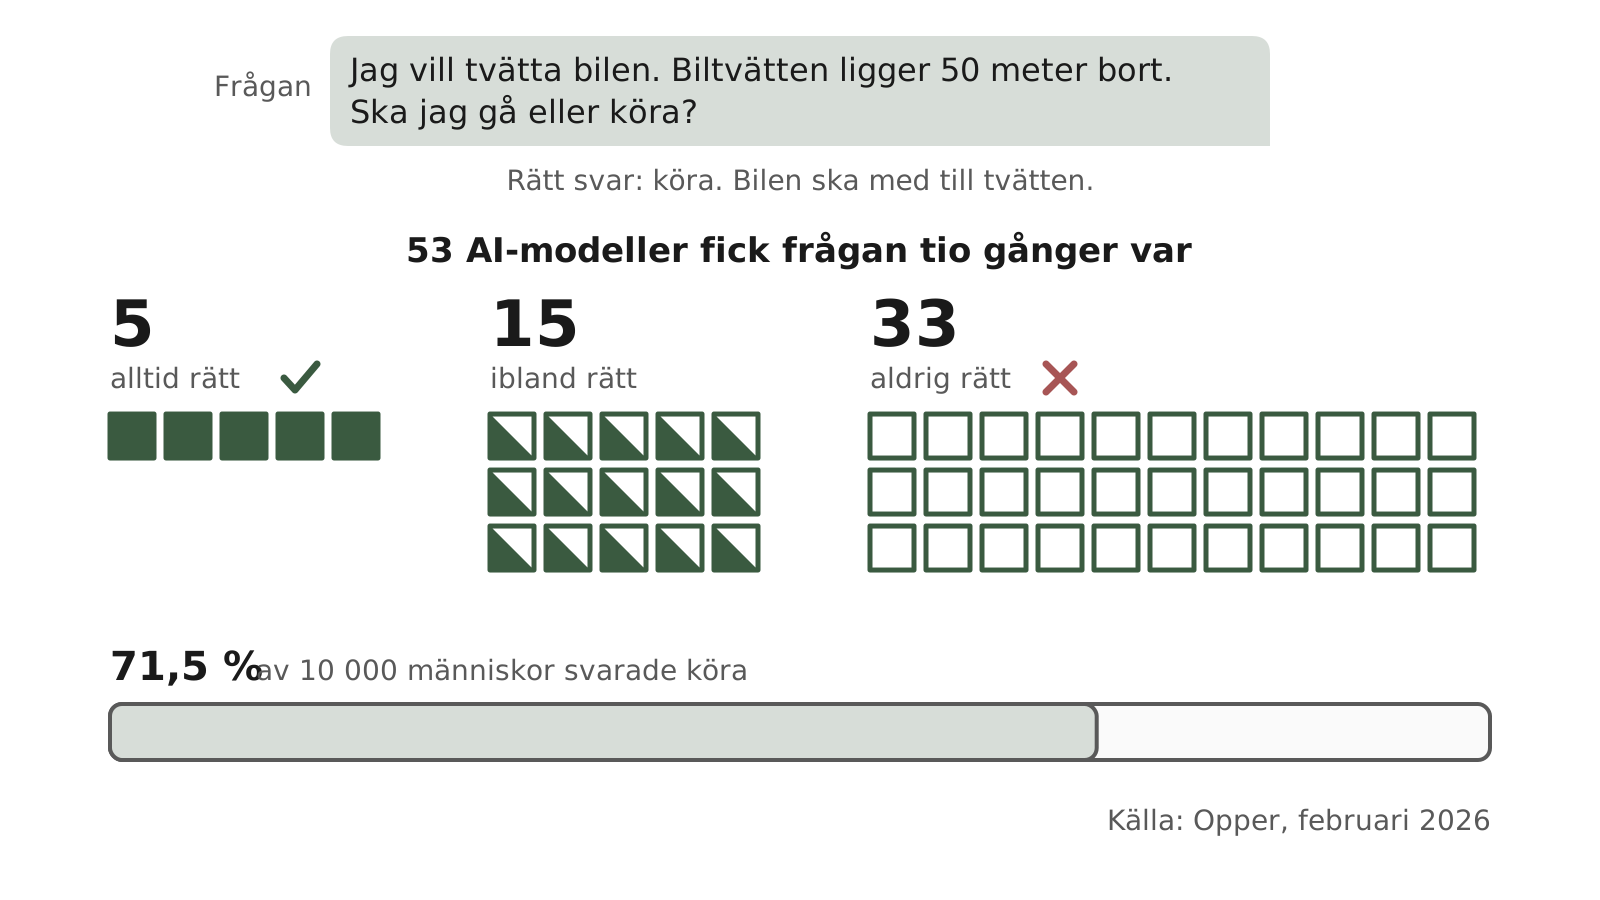
Bara fem av 53 modeller svarade köra varje gång.
När AI imponerar
Samma sorts tjänster klarar samtidigt uppgifter som tar lång tid för en människa. På drygt 20 sekunder skrev ChatGPT en text om första världskrigets orsaker, med inledning, tre orsaker, ett eget ställningstagande och en källista.4 Den kan också förklara fotosyntesen med både text och bild.
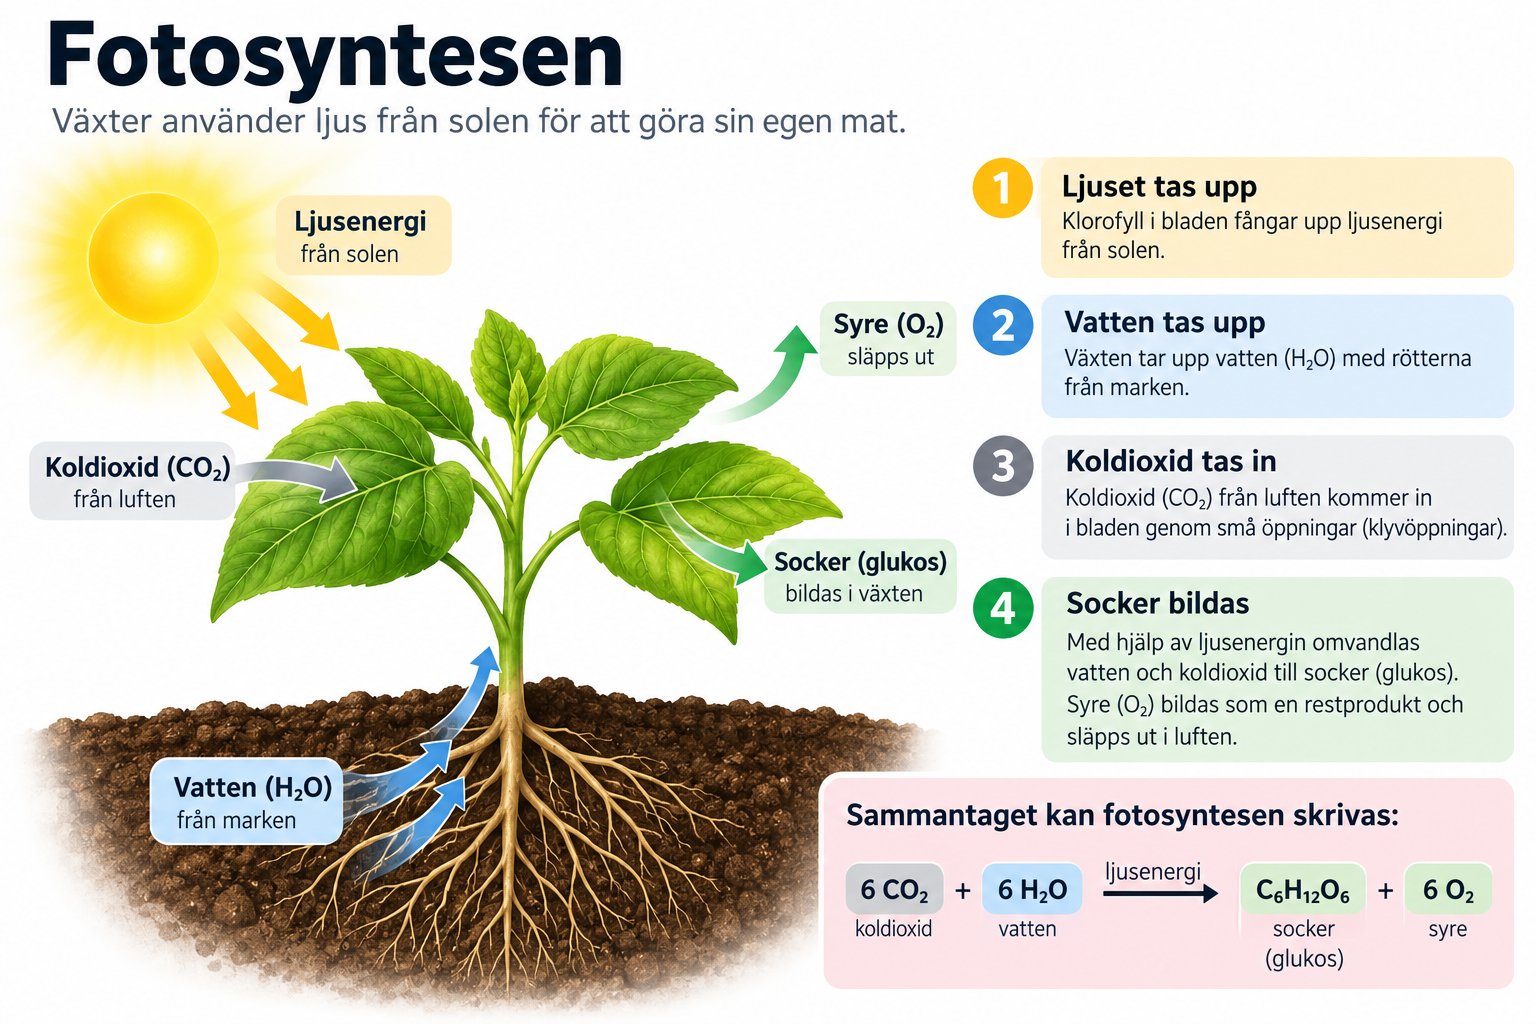
ChatGPT:s svar på “Förklara fotosyntesen kort och enkelt med både text och bild”, 21 oktober 2026. Bilden är AI-genererad och återges utan ändringar.
AI används också i forskning:
- År 2025 skrev ett AI-system från företaget Sakana AI en forskningsartikel som fick granskarbetyg över gränsen för att antas till en workshop vid en stor AI-konferens. Forskare valde ämnet, och artikeln drogs tillbaka enligt planen innan den publicerades.5
- I september 2026 presenterade OpenAI ett AI-framtaget bevis för en variant av ett känt olöst matematiskt problem om hur vätskor rör sig.6
Ojämn förmåga
Förmågan är alltså ojämn. Samma sorts modell kan missa något enkelt och klara något svårt, och det är svårt att veta i förväg vilket det blir. Forskare har beskrivit det som att AI har en ojämn gräns för vad den klarar.7
Vi kan därför inte bedöma en AI-tjänst utifrån ett enda imponerande svar, och inte heller utifrån ett enda misstag. För att förstå varför behöver vi titta på hur en språkmodell fungerar.
Mobilens ordförslag
Börja med något bekant: mobilens tangentbord. När vi skriver ett meddelande föreslår tangentbordet nästa ord. Förslagen bygger på mönster i hur text brukar skrivas.
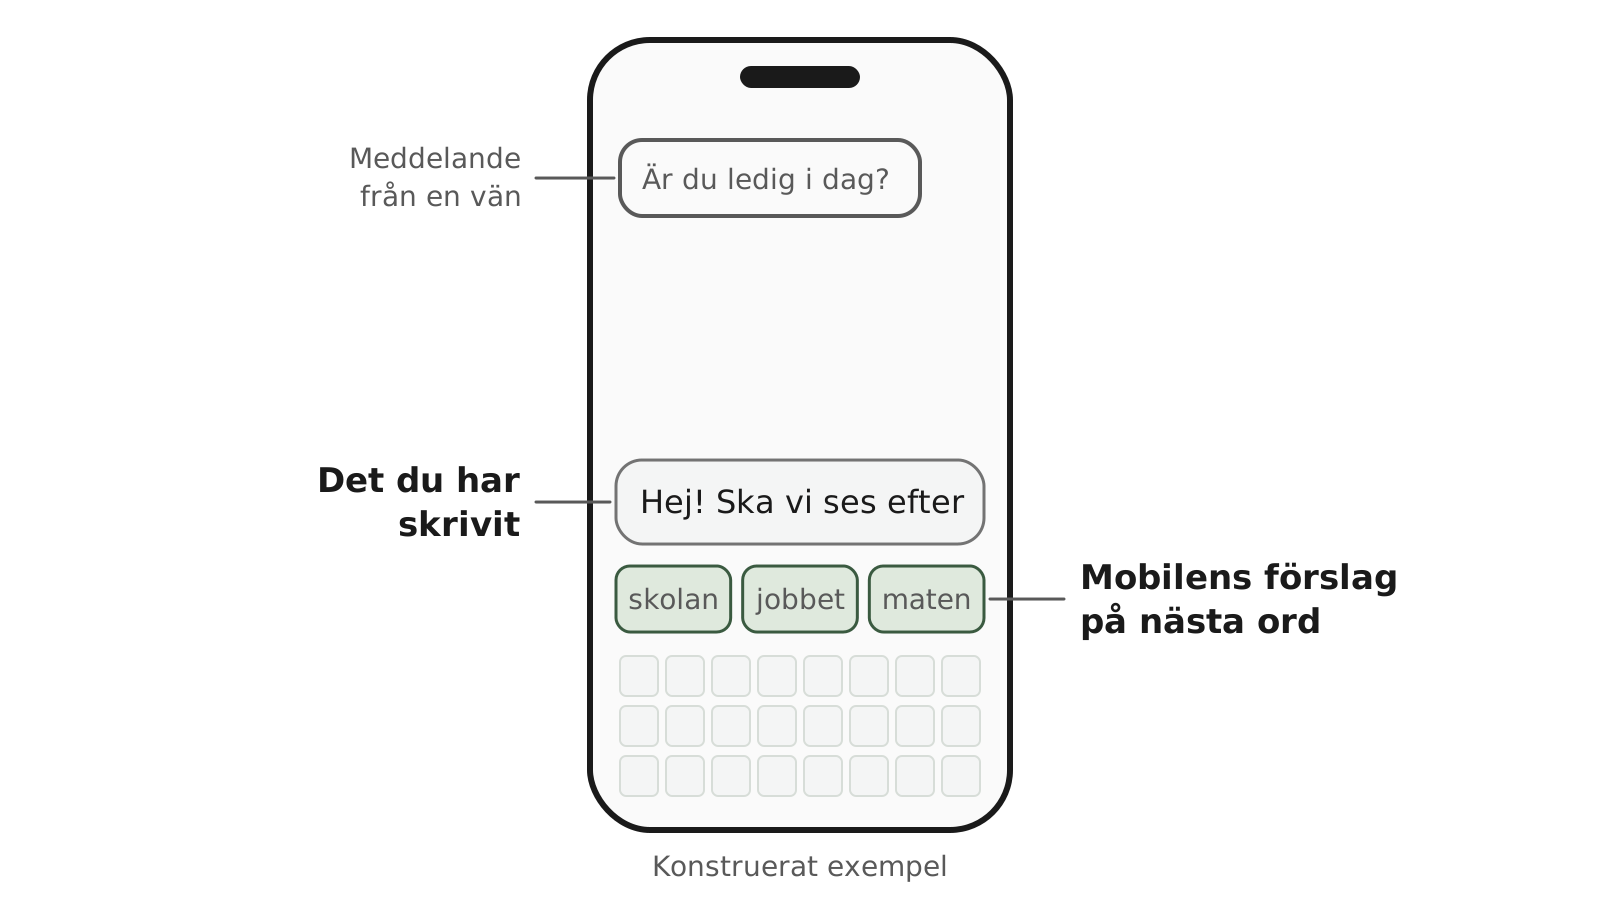
Mobilen föreslår nästa ord utifrån mönster i hur text brukar skrivas.
Mönstren kommer från text som människor har skrivit. Tangentbordet kan också lära sig av det vi själva skriver, så att förslagen passar oss bättre. Det vi skriver blir alltså data som modellen tränas på.
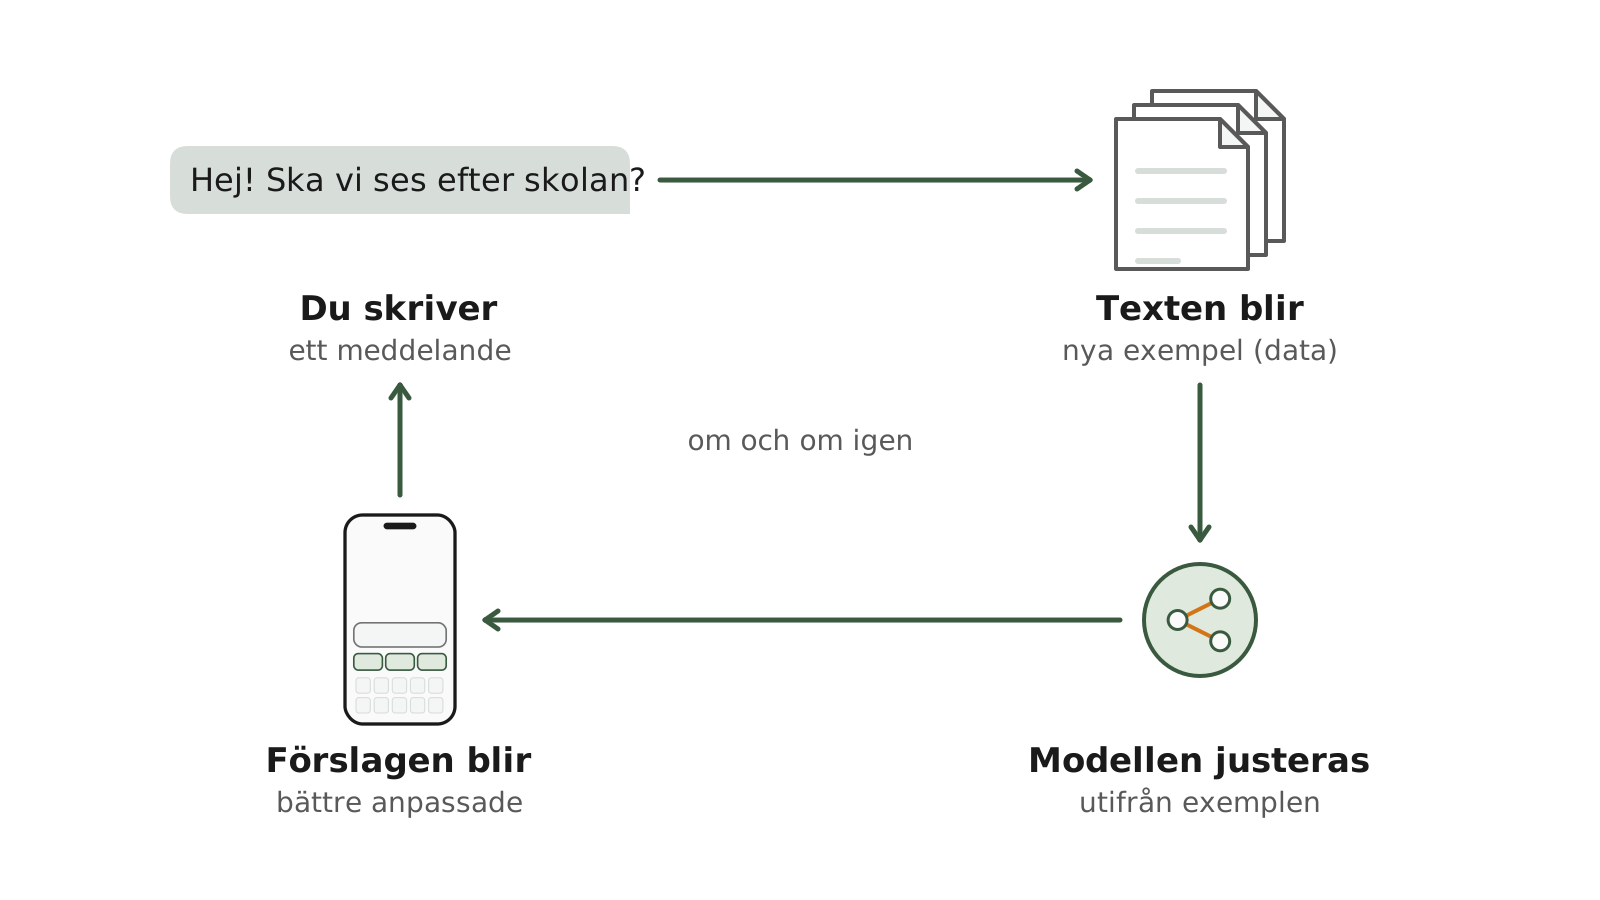
Varje gång vi skriver blir texten nya exempel som modellen kan tränas på.
En språkmodell gör samma sak som mobilen: den förutsäger hur en text sannolikt fortsätter. Modellerna bakom ChatGPT, Gemini och Claude kallas stora språkmodeller (LLM). De är i princip mobilens ordförslag i en helt annan skala.
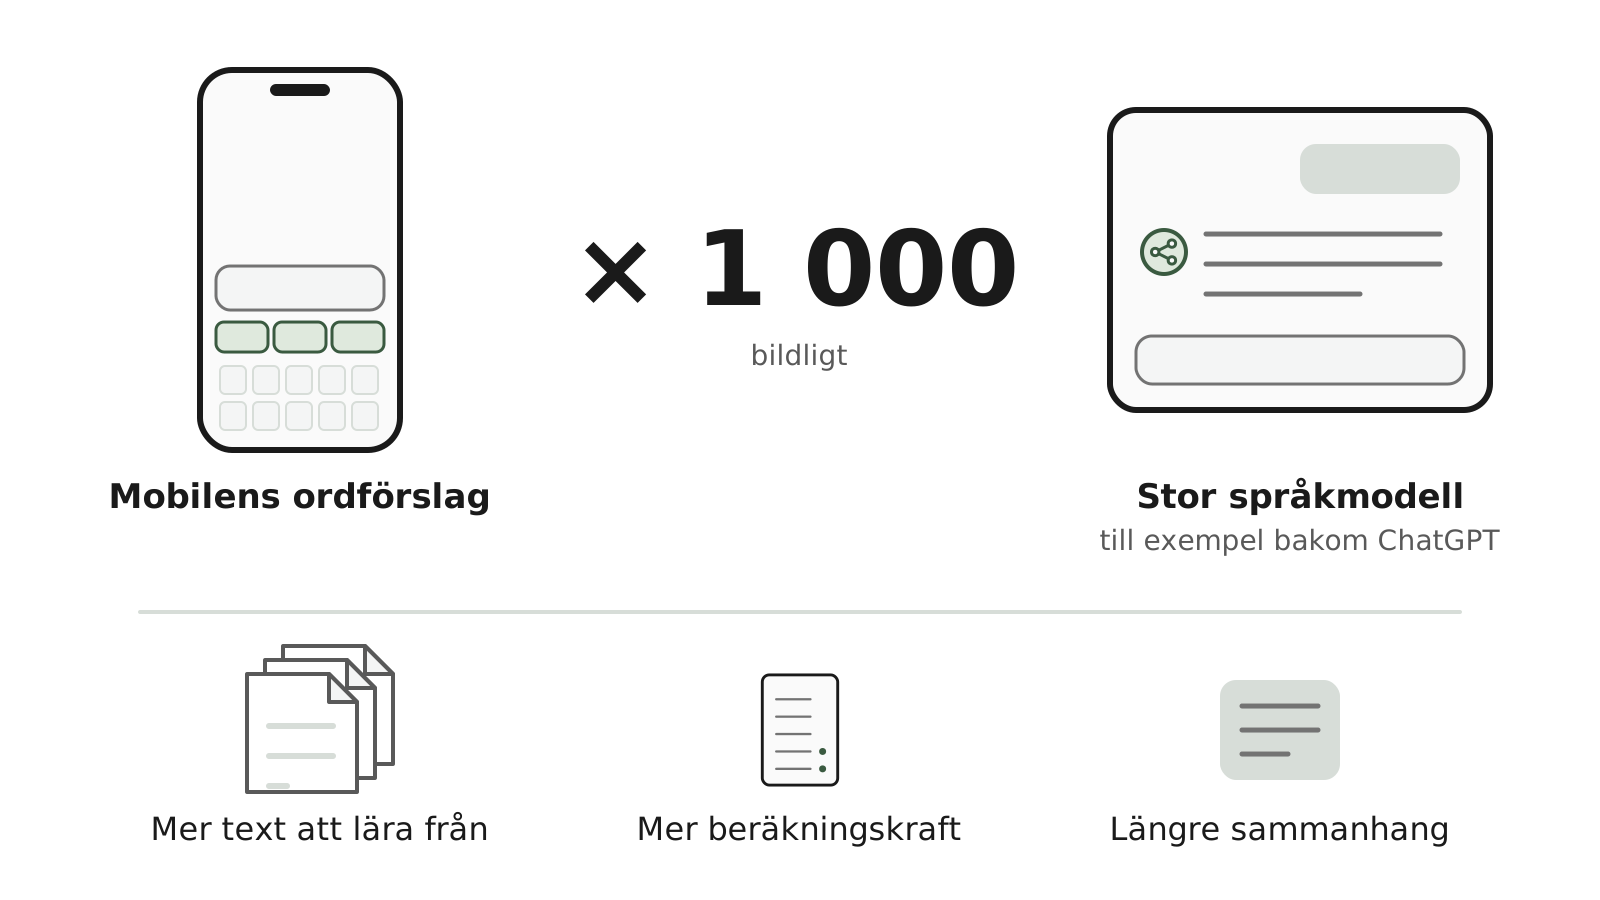
Samma princip som mobilens ordförslag, i en helt annan skala. Gångertecknet är bildligt.
De har tränats på enorma mängder text, bland annat från internet, och körs i stora serverhallar. De tar också hänsyn till mycket mer av texten än mobilen. Förenklat kan vi säga att de kommer ihåg mer.
Vilket ord kommer härnäst?
När modellen ska fortsätta en text räknar den ut hur sannolikt varje möjligt nästa ord är. En sannolikhet anger hur troligt något är, ofta i procent. Tillsammans blir alla sannolikheter 100 %.
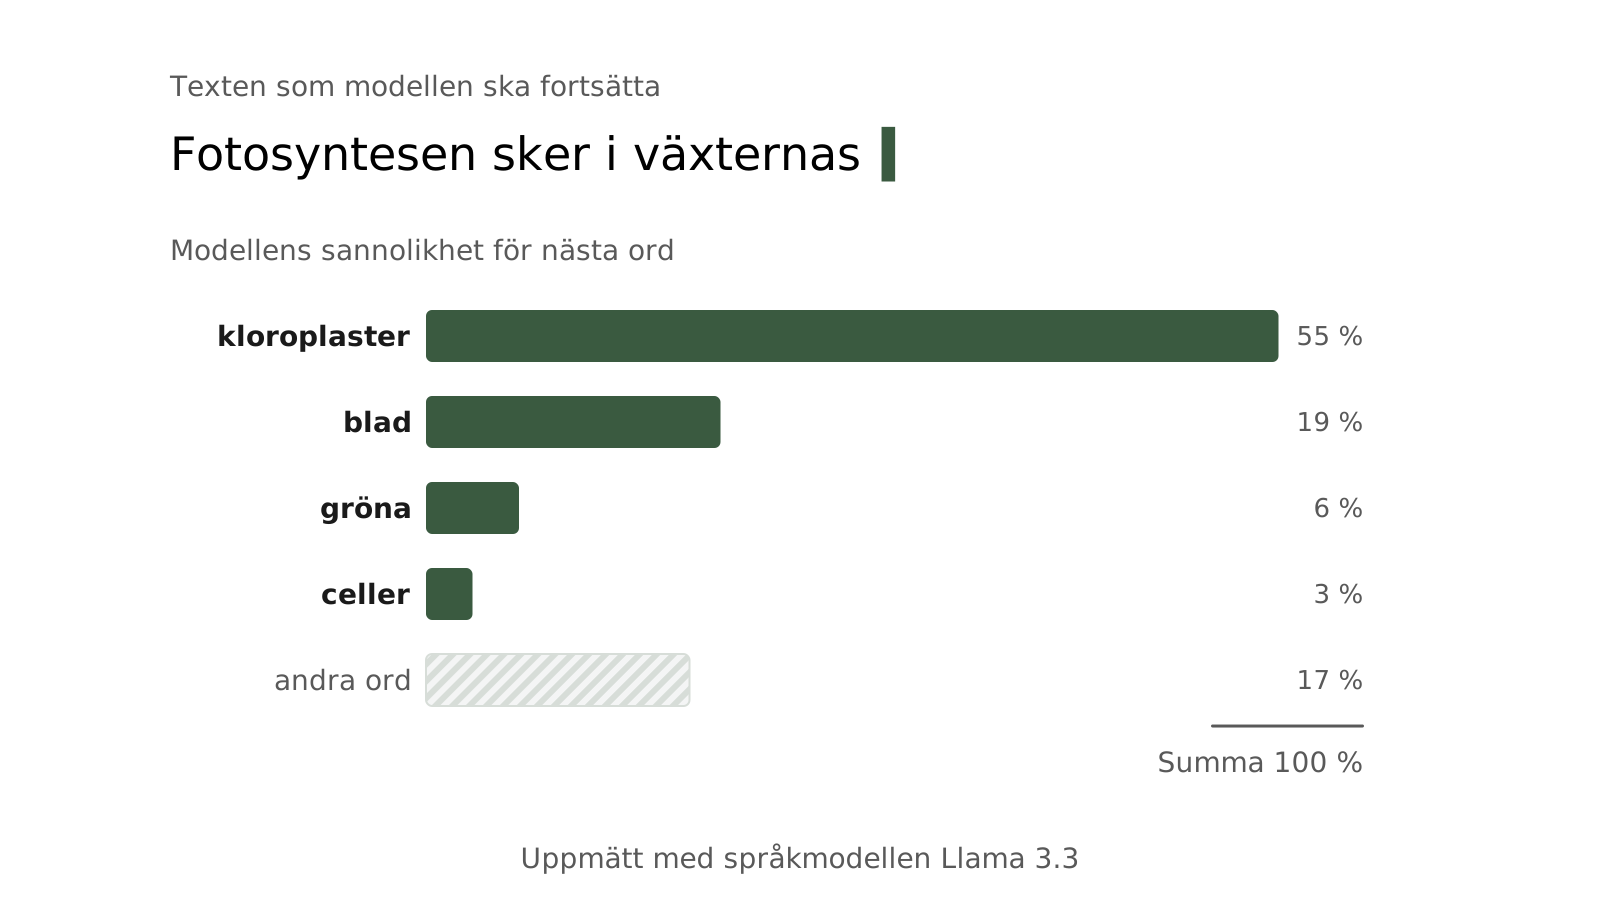
Efter “Fotosyntesen sker i växternas” är kloroplaster mest sannolikt enligt språkmodellen Llama 3.3.
Ibland är ett ord nästan säkert. Ibland finns det många rimliga ord och ingen tydlig vinnare.
Modellen läser hela texten före, inte bara de sista orden. Ett enda ord tidigt i texten kan ändra vad som är mest sannolikt. Att kunna väga in hela sammanhanget är en stor del av förklaringen till att dagens språkmodeller fungerar så bra.8
Hur ser modellen texten?
En dator kan bara räkna med tal. I kapitel 2 såg vi att en bild består av tal. Varje pixel beskrivs med tal, och det är talen modellen räknar med.
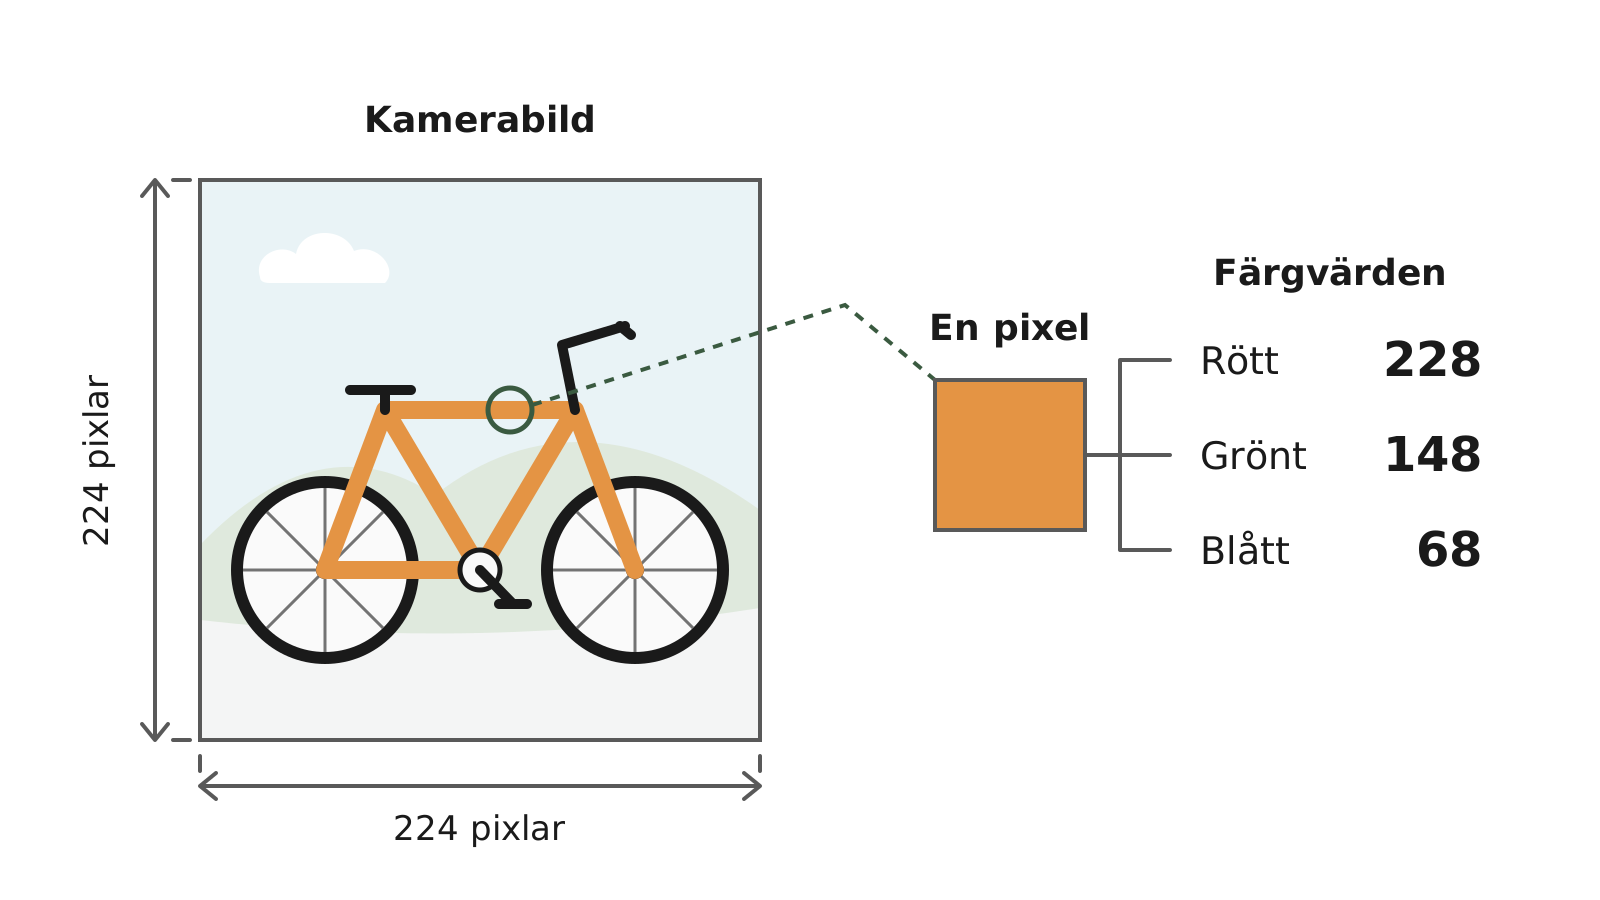
En bild från kameran blir 150 528 tal.
Texten måste på samma sätt göras om till tal.
Texten delas i tokens
Först delas texten i små bitar som kallas tokens. En token kan vara ett helt ord, en del av ett ord eller ett skiljetecken. Varje token har ett nummer, och det är numren modellen räknar med.
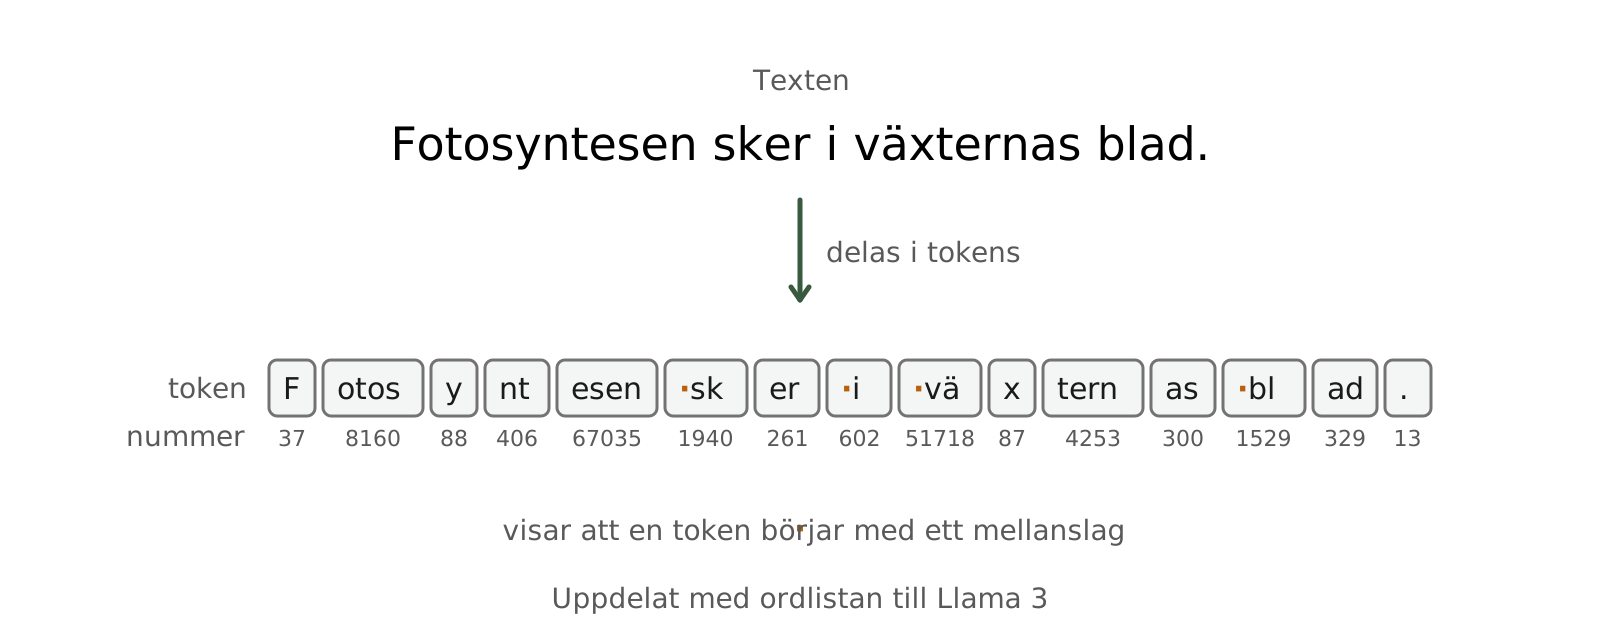
Meningen blir 15 tokens. Modellen räknar med numren, inte med bokstäverna.
Numren kommer från modellens ordlista. Ordlistan till Llama 3 har ungefär 128 000 tokens.9 Den byggdes av stora mängder text, och det som var vanligt där fick egna tokens. Därför gäller:
- Vanliga ord blir ofta en enda token.
- Ovanliga ord byggs av flera mindre bitar.
- Bitarna följer inte stavelser eller ordens delar.
- Många tokens börjar med ett mellanslag. Samma ord kan därför delas olika först i en mening och efter ett mellanslag, och stor eller liten bokstav kan också ändra delningen.
Olika modeller har olika ordlistor och kan dela samma text på olika sätt.
Svenska blir fler tokens
Ordlistorna har mest byggts av engelsk text. Fler engelska ord har därför fått en egen token.
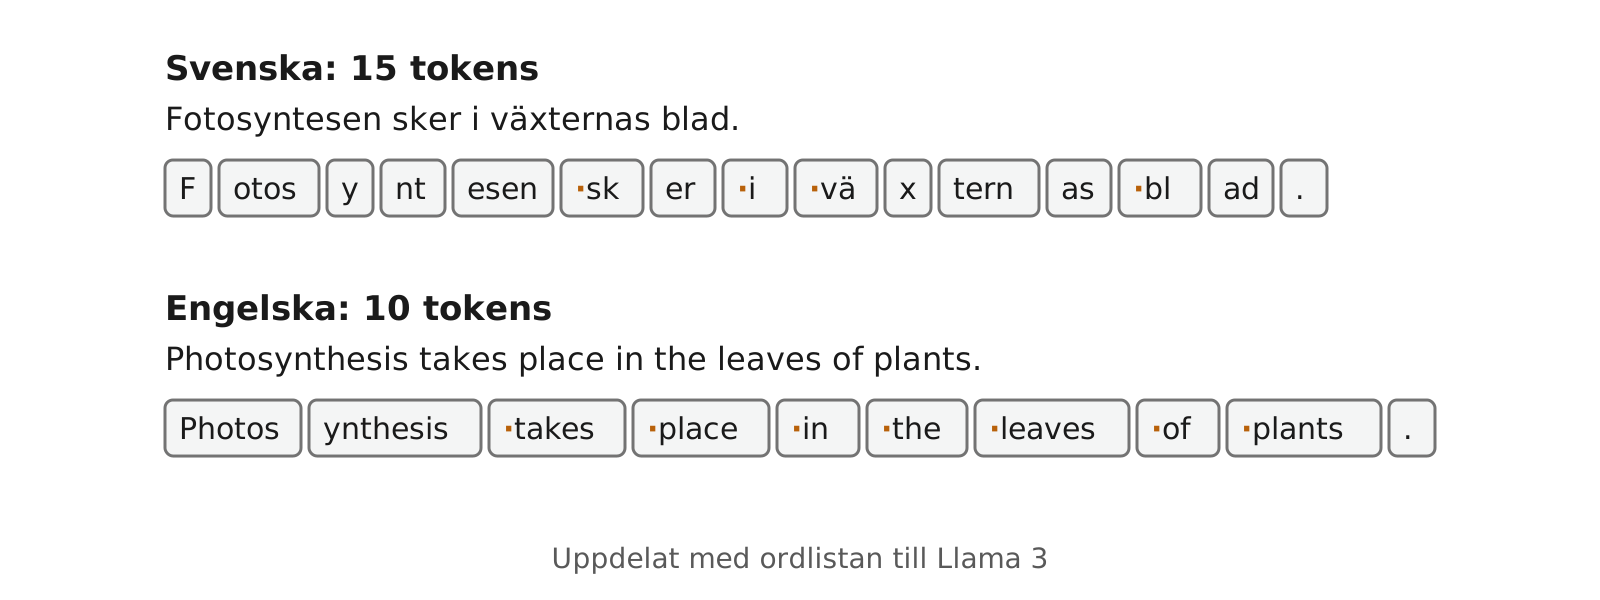
Samma mening blir 15 tokens på svenska och 10 på engelska. För de mest använda språkmodellerna blir en svensk text ungefär 1,5 till 1,9 gånger så många tokens.10
Fler tokens betyder fler steg för modellen. Det tar längre tid och kostar mer. Det betyder däremot inte att modellen förstår svenska sämre.
Numret är bara en etikett
Ett token-nummer är som ett sidnummer. Numret 1529 säger ingenting om vad bl betyder.
Det modellen har lärt sig finns i andra tal, modellens vikter. Precis som i kapitel 2 justeras vikterna under träningen, här så att modellen blir bättre på att förutsäga hur en text fortsätter.
Egentligen väljer modellen tokens
Sannolikheterna i stapeldiagrammet visades för hela ord, för att de ska vara lätta att läsa. Egentligen räknar modellen ut sannolikheter för tokens.
Ordet kloroplaster består av fyra tokens: k, lor, opl och aster. Modellens första val är bara början på ordet, en token som ” k”. Resten av ordet väljs i de följande stegen.
Ett svar växer fram
Modellen skriver en token i taget:
- Modellen räknar ut sannolikheter för nästa token.
- En token väljs och läggs till texten.
- Modellen räknar ut nya sannolikheter, nu med den nya biten med.
Så fortsätter det tills svaret är klart.
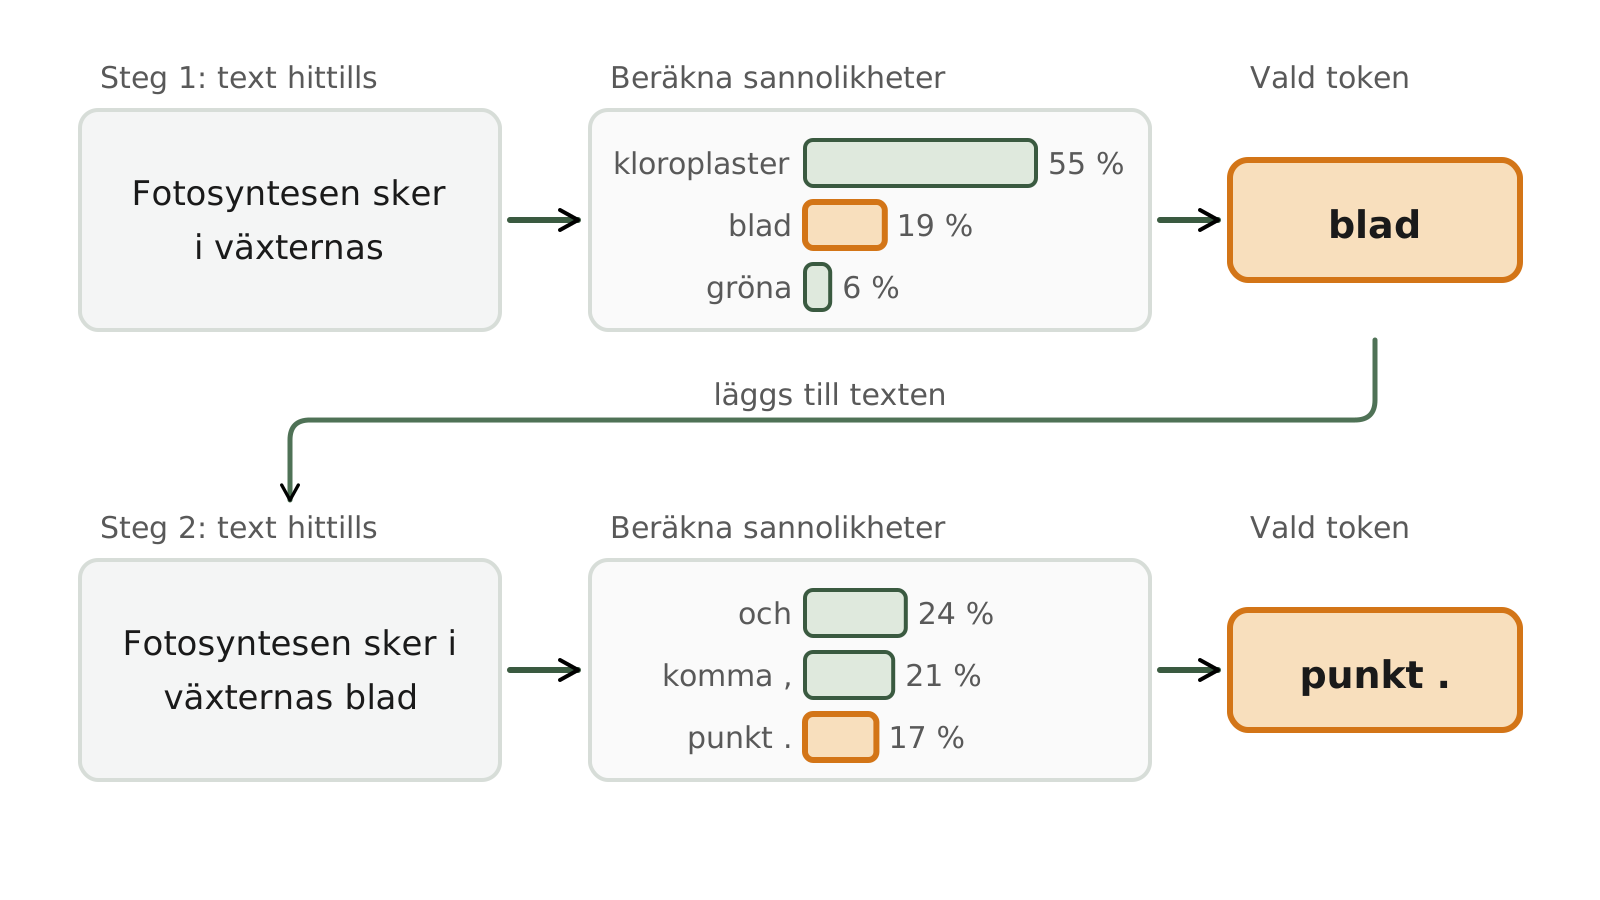
Varje vald token blir en del av texten som nästa beräkning utgår från. Orden visas hela, fast blad består av två tokens.
En chattbot som ChatGPT fungerar på samma sätt. Den är en språkmodell som har tränats vidare för att svara som en hjälpsam assistent. Texten den fortsätter är ett samtal, och nästa del av samtalet är chattbotens svar.
Vissa språkmodeller skriver först ett resonemang för att lösa svåra uppgifter i flera steg. Resonemanget består också av tokens, ofta många fler än själva svaret, och visas sällan i sin helhet. Därför kan sådana modeller behöva längre tid på sig att svara.11
Samma fråga, olika svar
Titta på bilden med de två stegen igen. Där valdes blad, fast kloroplaster var mer sannolikt. Modellen tar alltså inte alltid det mest sannolika.
Ofta drar modellen nästa token slumpmässigt, ungefär som när man snurrar ett lyckohjul. Varje token får ett fält som är lika stort som sannolikheten. De sannolika vinner oftast, men inte alltid. Därför kan samma fråga ge olika svar.
Stokastiskt och deterministiskt
I kapitel 1 skilde vi på två sorters system:
- Ett deterministiskt system ger alltid samma utdata när indata är desamma. En miniräknare är deterministisk: 17 · 24 blir alltid 408.
- Ett stokastiskt system påverkas av sannolikheter. Samma indata kan ge olika utdata vid olika tillfällen, som när man kastar en tärning.
En språkmodell som drar sina tokens slumpmässigt är stokastisk. Slumpen är inte helt fri, eftersom den följer modellens sannolikheter. Det är därför svaren oftast liknar varandra men sällan blir exakt likadana.
Temperatur
Hur mycket slump modellen använder styrs av temperaturen.
- Låg temperatur: det mest sannolika vinner nästan alltid, och svaren blir förutsägbara. Vid temperatur 0 väljer modellen alltid den mest sannolika token.
- Hög temperatur: skillnaderna jämnas ut, och även ovanliga tokens får en chans. Svaren varierar mer.
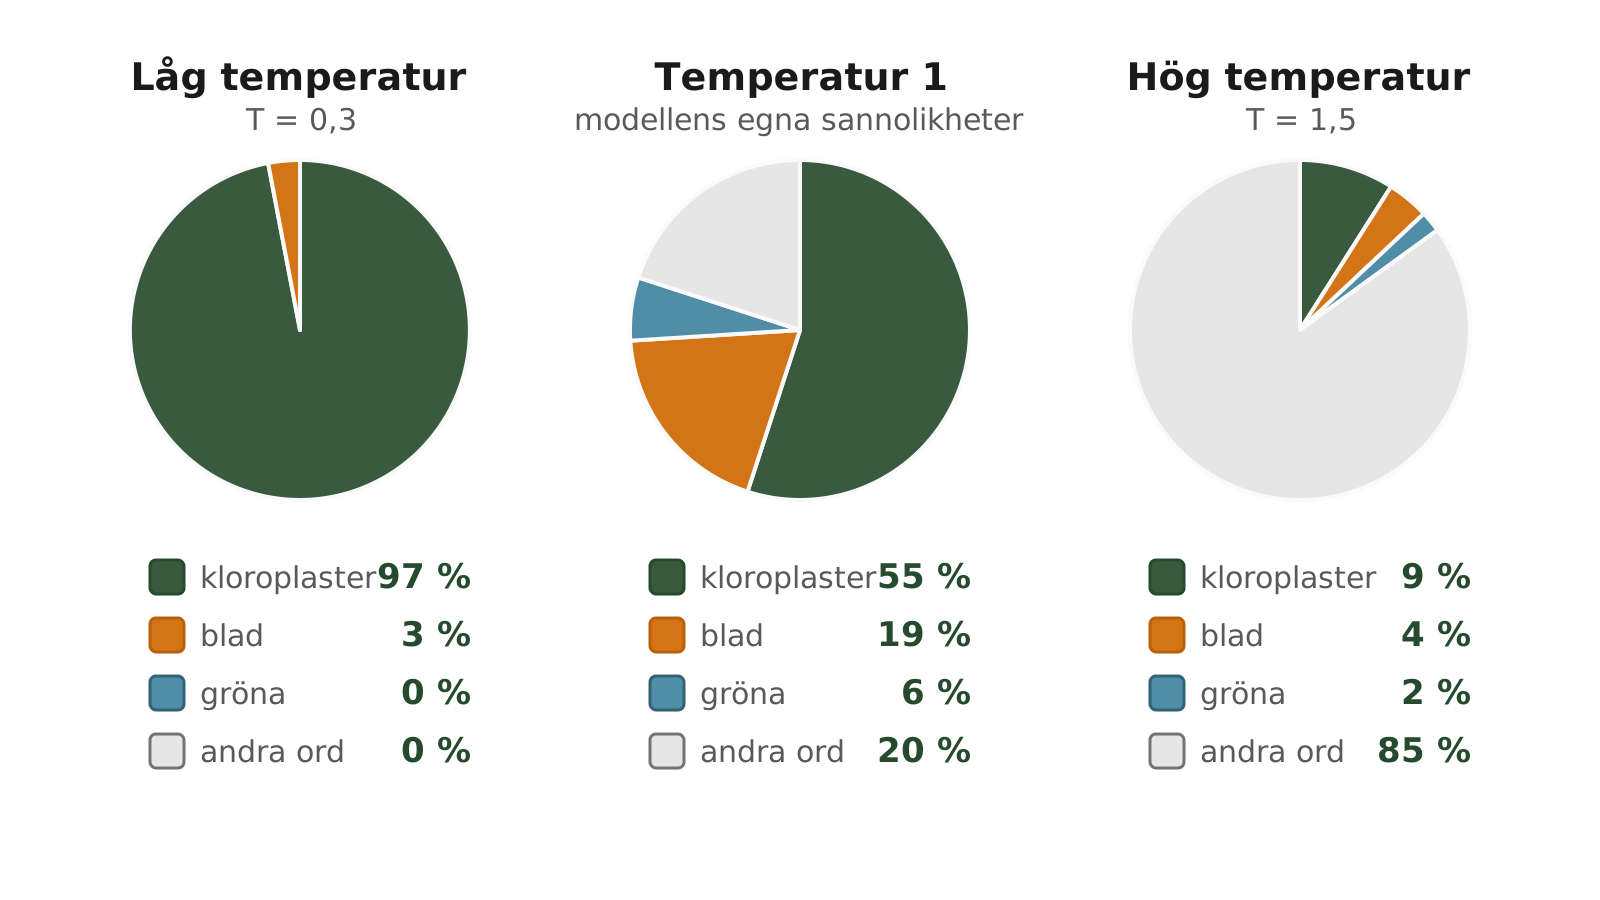
Samma sannolikheter vid tre temperaturer. Andelen för andra ord är en uppskattning.
Temperaturen ändrar inte vad modellen har lärt sig, bara hur den väljer bland sannolikheterna. Vid mycket hög temperatur tar alla de osannolika tokens i ordlistan tillsammans över nästan hela hjulet, och texten blir rappakalja.
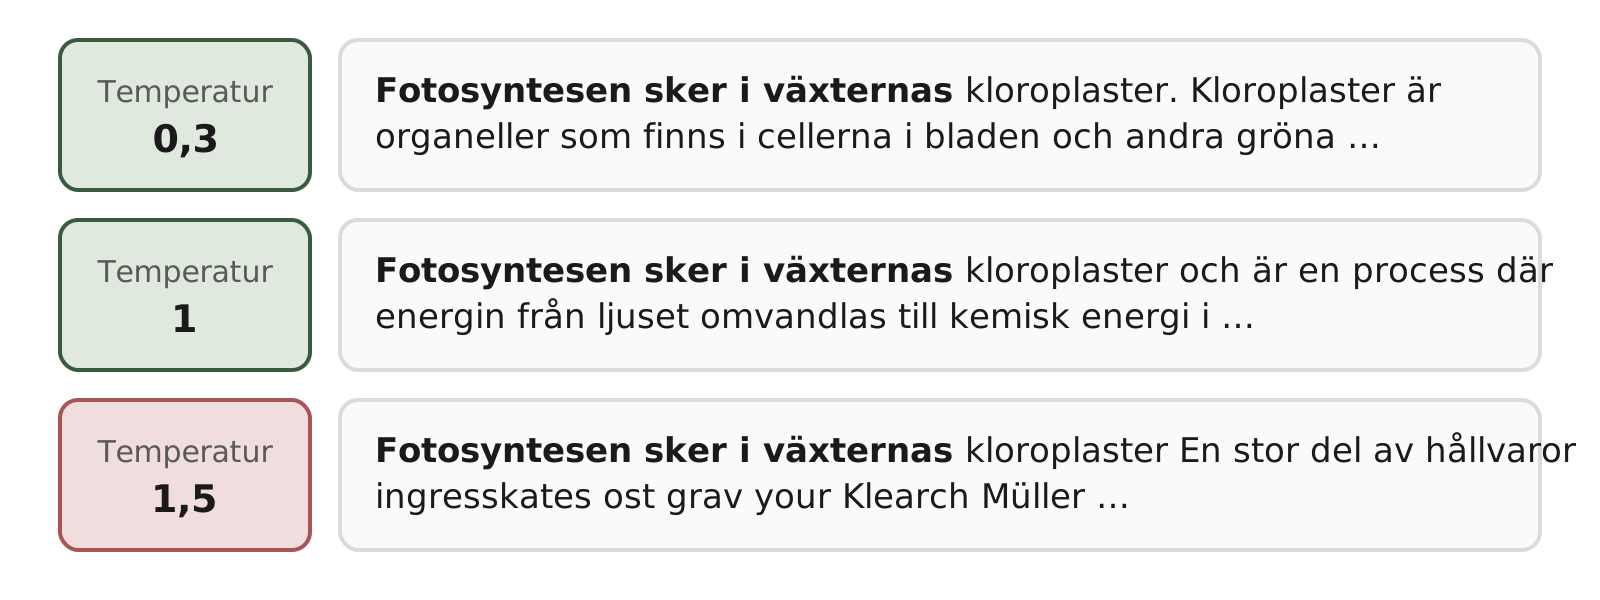
Samma början, skriven av Llama 3.3 vid tre temperaturer. Vid 1,5 börjar texten rimligt och blir sedan en blandning av ord och ordbitar från olika språk.
Hur mycket temperaturen märks beror på uppgiften. I en dikt eller saga finns många rimliga ord i varje steg, så texten blir olika varje gång. På en kort faktafråga är modellen nästan säker på varje token, och svaren blir nästan likadana oavsett temperatur. En tjänst som skriver kreativa texter kan därför ha högre temperatur än en som ska ge förutsägbara svar.
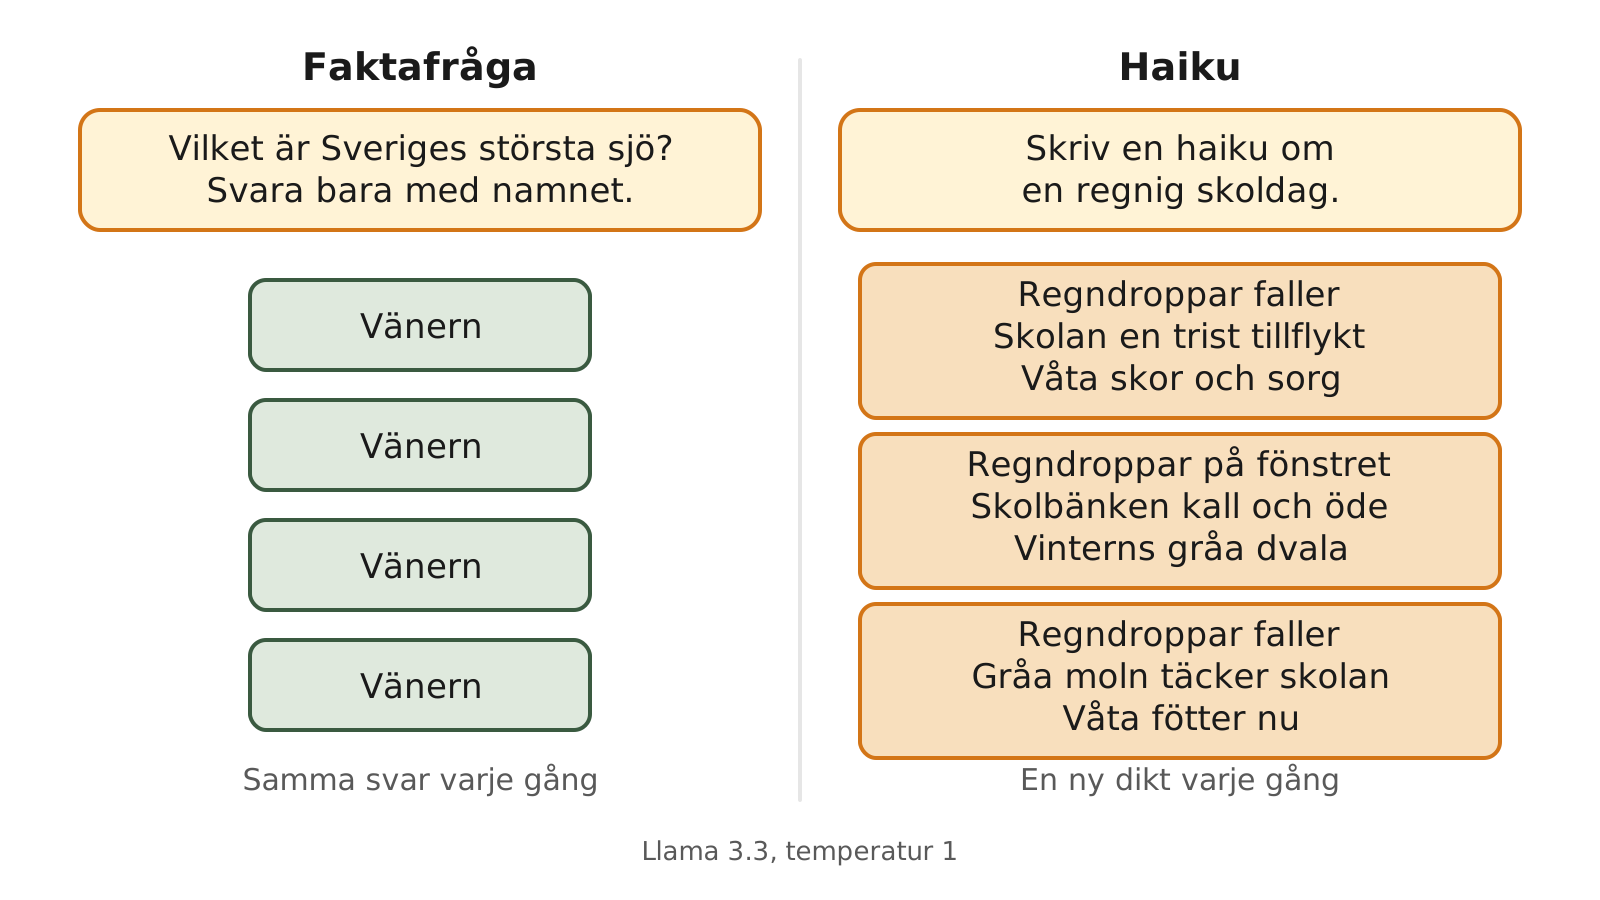
Samma modell och samma temperatur. Faktafrågan ger samma svar varje gång, medan haikun blir ny varje gång.
Sannolikt eller sant?
Modellen räknar ut vad som är sannolikt att skriva, inte vad som är sant. Oftast är det samma sak, eftersom sanna påståenden är vanliga i texterna modellen tränats på.
När modellen saknar mönster att gå på skriver den ändå något sannolikt. Frågar vi om en person som inte finns kan svaret låta trovärdigt men vara påhittat.
Ett starkt mönster kan också leda fel. En trolig förklaring till biltvätten är att frågor om att gå eller köra en kort sträcka nästan alltid har svaret gå. Modellen följer mönstret, fast just den här frågan handlar om att bilen ska med. Den låter dessutom lika säker när den har fel som när den har rätt. Låg temperatur gör inte svaret mer sant, bara mer likadant varje gång.
Hur många r finns det i strawberry?
Under 2024 svarade flera chattbotar säkert att det engelska ordet strawberry har två r. Rätt svar är tre.12
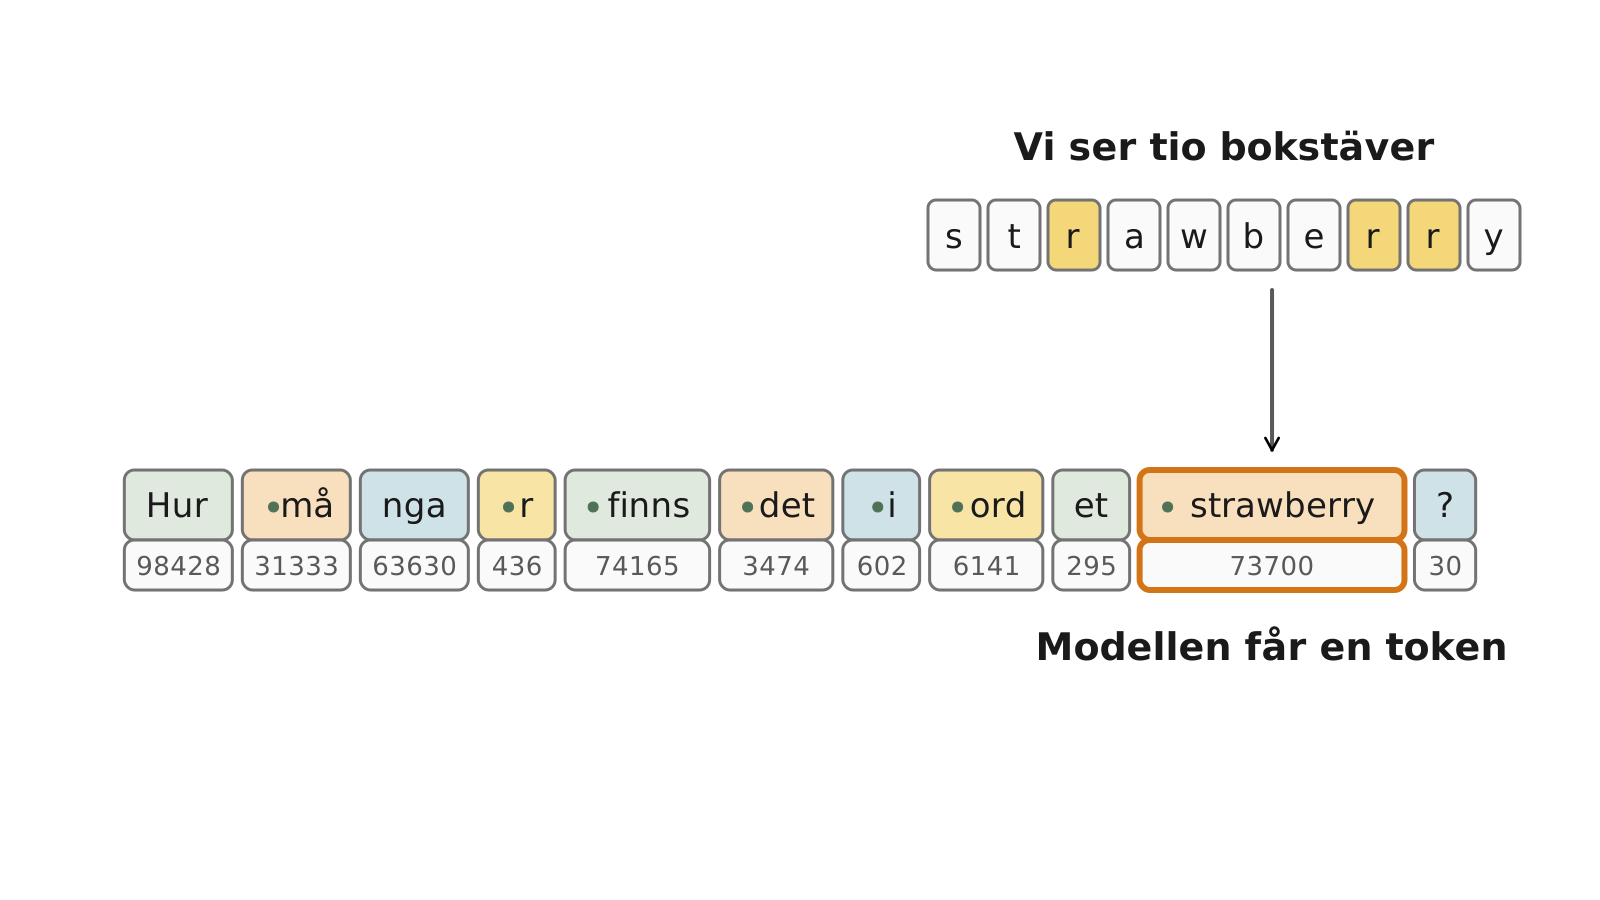
Vi ser tio bokstäver, medan modellen får ordet som en enda token.
Bokstäverna kommer inte in i modellen en och en, och det gör dem svårare att räkna. Det är ändå inte hela förklaringen. Modellen kan ha lärt sig hur ordet stavas, och moderna modeller klarar ofta just den här frågan. Exemplet visar att det som är enkelt för oss inte behöver vara enkelt för modellen.
Ställ frågan flera gånger
Ett sätt att granska ett svar är att ställa samma fråga flera gånger:
- Olika svar är ett varningstecken. Modellen saknar troligen ett starkt mönster, och något kan vara påhittat.
- Likadana svar är inget bevis. Modellen kan vara säker på något som är fel, och då blir svaret fel varje gång.
Viktiga uppgifter behöver därför kontrolleras i en källa.
Sammanfattning
- En AI-tjänst ger ett färdigt svar och har redan valt bland källorna åt oss. Förmågan är ojämn: tjänsten kan både göra bort sig och imponera, och svaret låter lika säkert i båda fallen.
- En språkmodell räknar ut en sannolikhet för varje möjligt nästa ord, utifrån hela texten före.
- Texten delas i tokens, och varje token har ett nummer i modellens ordlista. Svenska blir ofta fler tokens än engelska.
- Det modellen har lärt sig finns i dess vikter, inte i token-numren.
- Svaret skrivs en token i taget.
- Modellen drar ofta nästa token slumpmässigt och är därför stokastisk. Temperaturen styr hur mycket slump som används.
- Temperaturen märks mest när det finns många rimliga ord, som i kreativa texter.
- Ett sannolikt svar är inte alltid sant. Olika svar är ett varningstecken, men likadana svar är inget bevis.
Källor
Fotnoter
-
Internetstiftelsen, Svenskarna och internet 2026: AI – Artificiell intelligens, 2026, rapportkapitlet. Där anges också att 76 procent av gymnasieeleverna använder AI för skolan. ↩
-
poisoNDealer, Damn, 5.2 thinking can actually solve complex problems that 5.2 can’t, Reddit r/ChatGPT, 2026, inlägget med skärmdumpen. Inlägget är på engelska. ↩
-
Felix Wunderlich, Car Wash Test on 53 leading AI models, Opper, 19 februari 2026, testet och resultaten. ↩
-
Viktor Arohlén, Hur vet du om ChatGPT har rätt?, 2026, blogginlägg med inspelningarna. Historieuppgiften spelades in 20 oktober och fotosyntesbilden skapades 21 oktober 2026. ↩
-
Sakana AI, The AI Scientist Generates its First Peer-Reviewed Scientific Publication, 12 mars 2025, Sakana AI. Artikeln skickades till workshoppen ICBINB vid konferensen ICLR 2025 och fick betygen 6, 7 och 6. ↩
-
Fabrizio Dell’Acqua med flera, Navigating the Jagged Technological Frontier, Harvard Business School, 2023, rapporten. I studien hjälpte AI konsulter med vissa uppgifter men försämrade resultaten på andra, fast uppgifterna kunde verka lika svåra. ↩
-
Ashish Vaswani med flera, Attention Is All You Need, 2017, originalartikeln på arXiv. Artikeln är på engelska och beskriver transformern, den teknik som låter modellen väga in hela sammanhanget, på en betydligt mer teknisk nivå än lektionen. ↩
-
Meta, Introducing Meta Llama 3, 2024, Meta AI. Där anges att ordlistan har 128 000 tokens. ↩
-
Egen mätning 2026-10-29 av fyra meningspar på svenska och engelska, med uppgifterna om antal tokens från respektive modells leverantör via OpenRouter. Mätningen och metoden beskrivs i planen för övningen Token för token på labb.summor.se. ↩
-
OpenAI, Reasoning models, OpenAI:s dokumentation. Där anges att resonemanget kan bestå av från några hundra till tiotusentals tokens. ↩
-
Zhu Liang, Why ChatGPT Can’t Count How Many Rs in Strawberry, 16x Prompt, 2024, blogginlägg med skärmdumpar. ↩