

4. Vad finns bakom språkmodellerna?
Två språkmodeller kan ge olika svar på samma fråga. När vi väljer modell behöver vi undersöka hur väl den klarar uppgiften, men också vad användningen kostar och vilka resurser den kräver.
Tänk dig att du vill ha hjälp att granska en rapport. Modellen behöver upptäcka motsägelser utan att hitta på egna fel. Hur kan du välja en modell som fungerar för uppgiften? Och vad kan modellens storlek, utvecklare och tillgången till dess vikter säga dig om valet?
Du har kanske använt ChatGPT från OpenAI, Gemini-appen från Google eller mött AI-svar i Google Sök. Andra exempel är Claude, Grok, Microsoft Copilot, Vibe, DeepSeek och Kimi. Bakom tjänsterna finns olika företag och modeller. Gemini-modeller används också i AI-funktioner i Google Sök.1
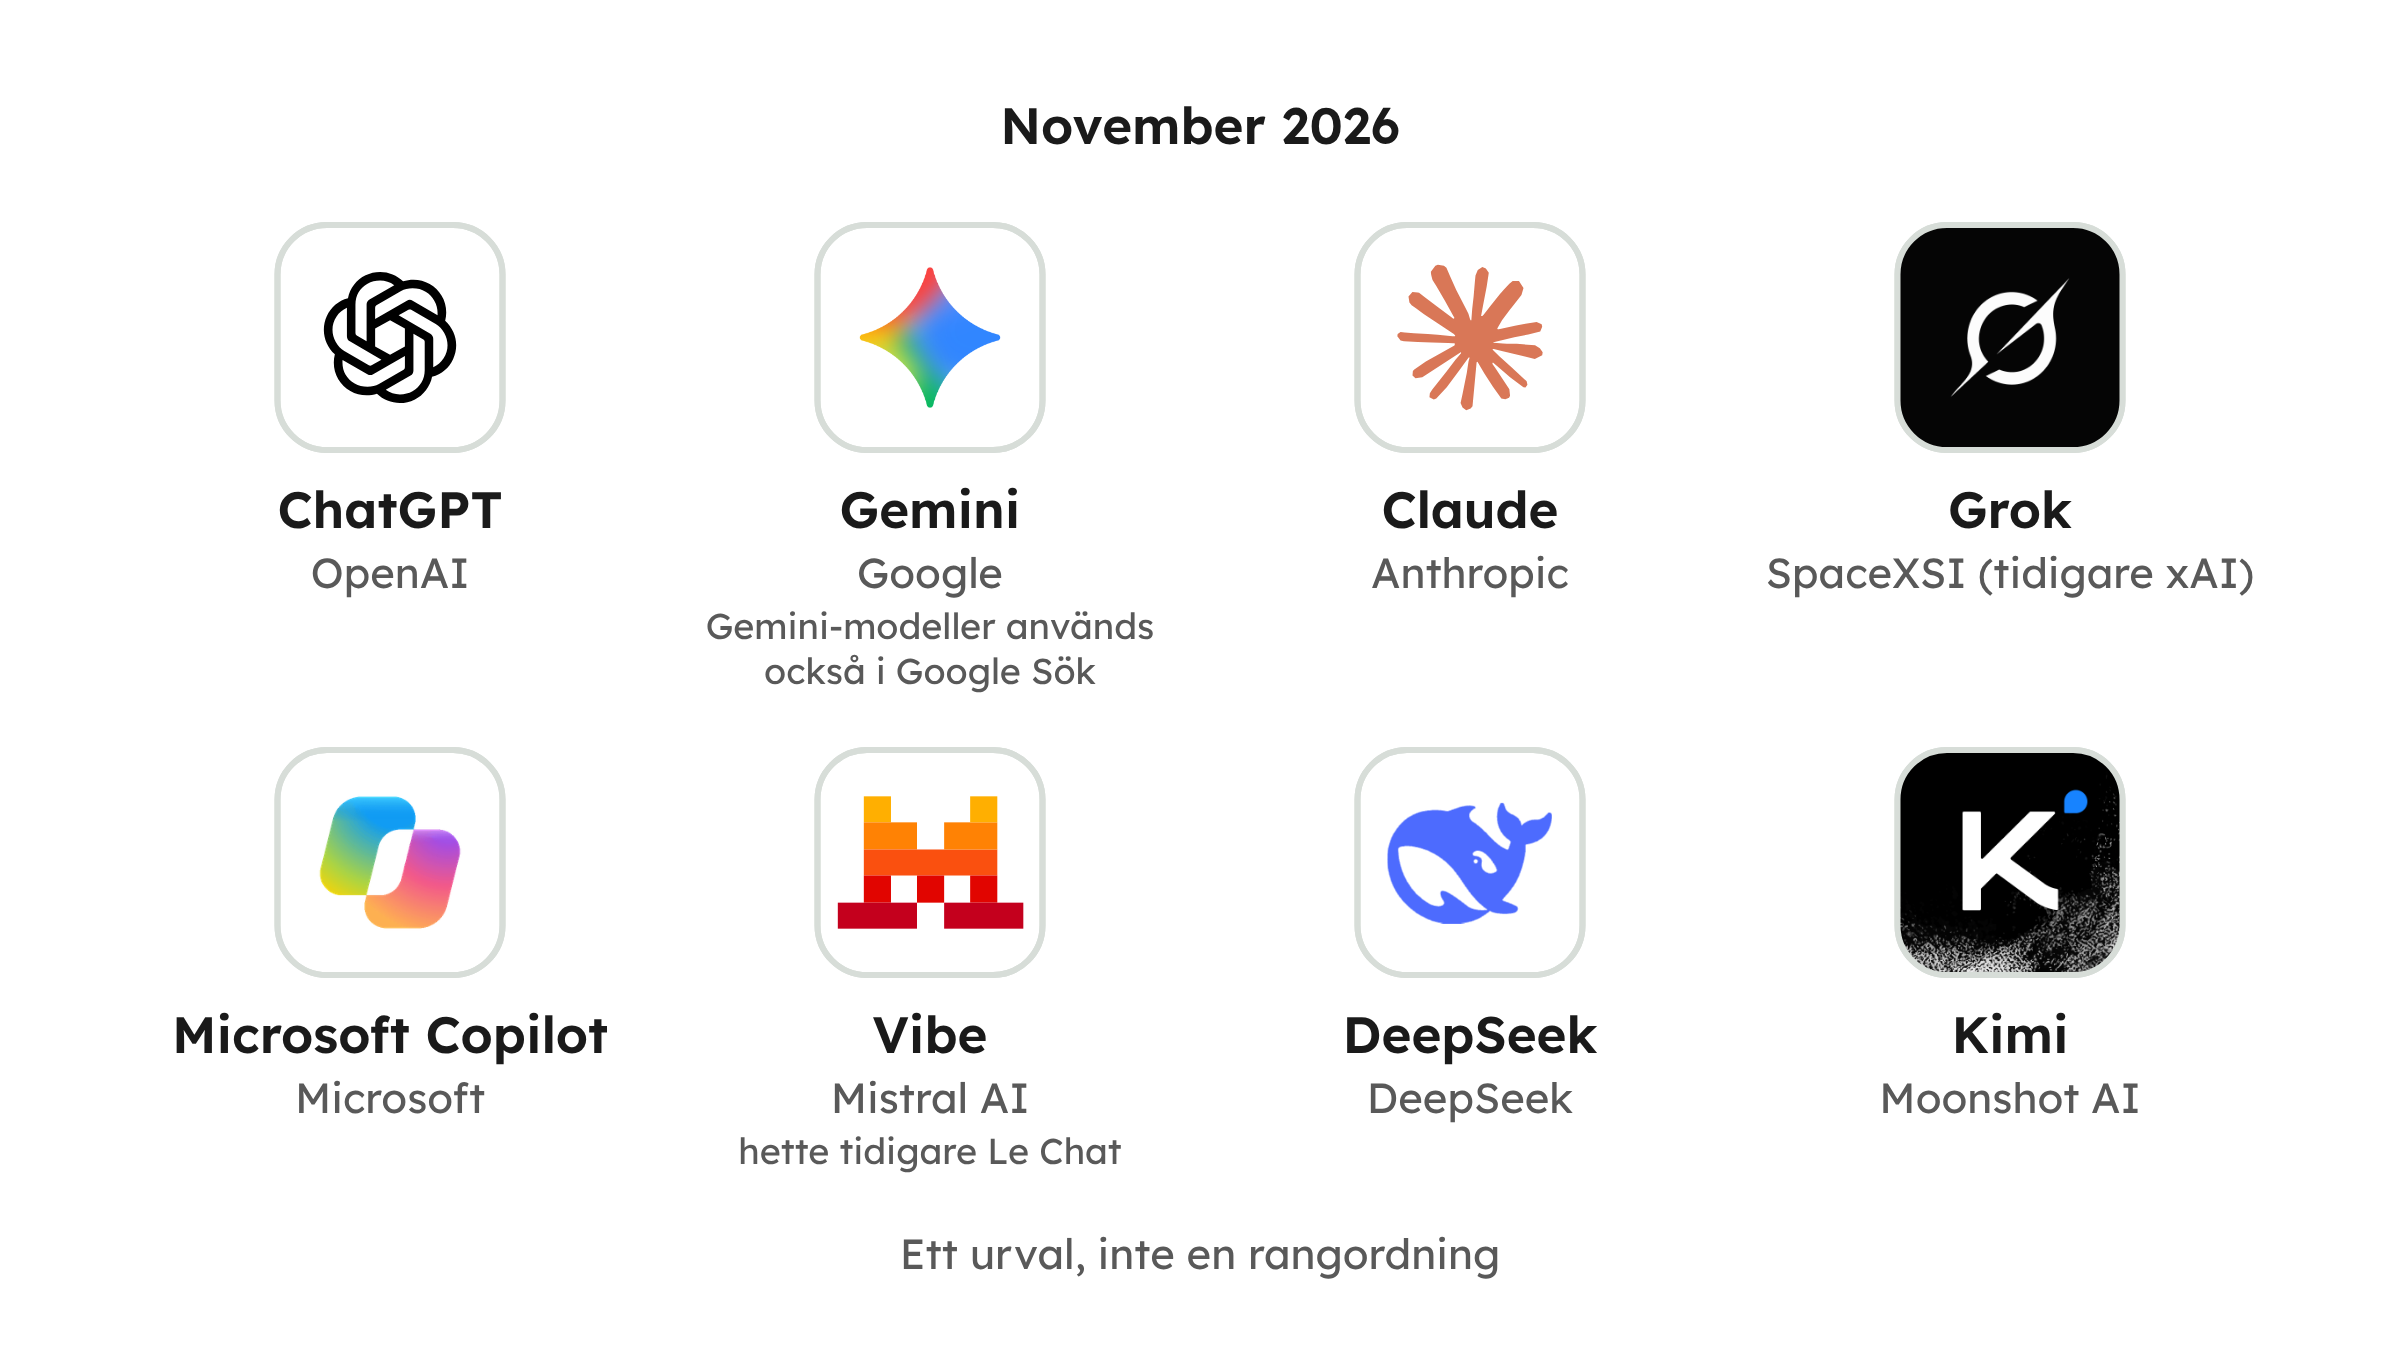
Några tjänster där du kan möta språkmodeller, november 2026. Tjänsterna kommer från olika företag och kan använda olika modeller. Namn och utbud förändras över tid.234
Modellen är en del av tjänsten
När du skriver till en chattbot använder du en tjänst. Tjänsten tar emot ditt meddelande, skickar indata till en språkmodell och visar svaret. Som vi såg tidigare kan den också lägga till instruktioner och tidigare meddelanden i modellens kontext.
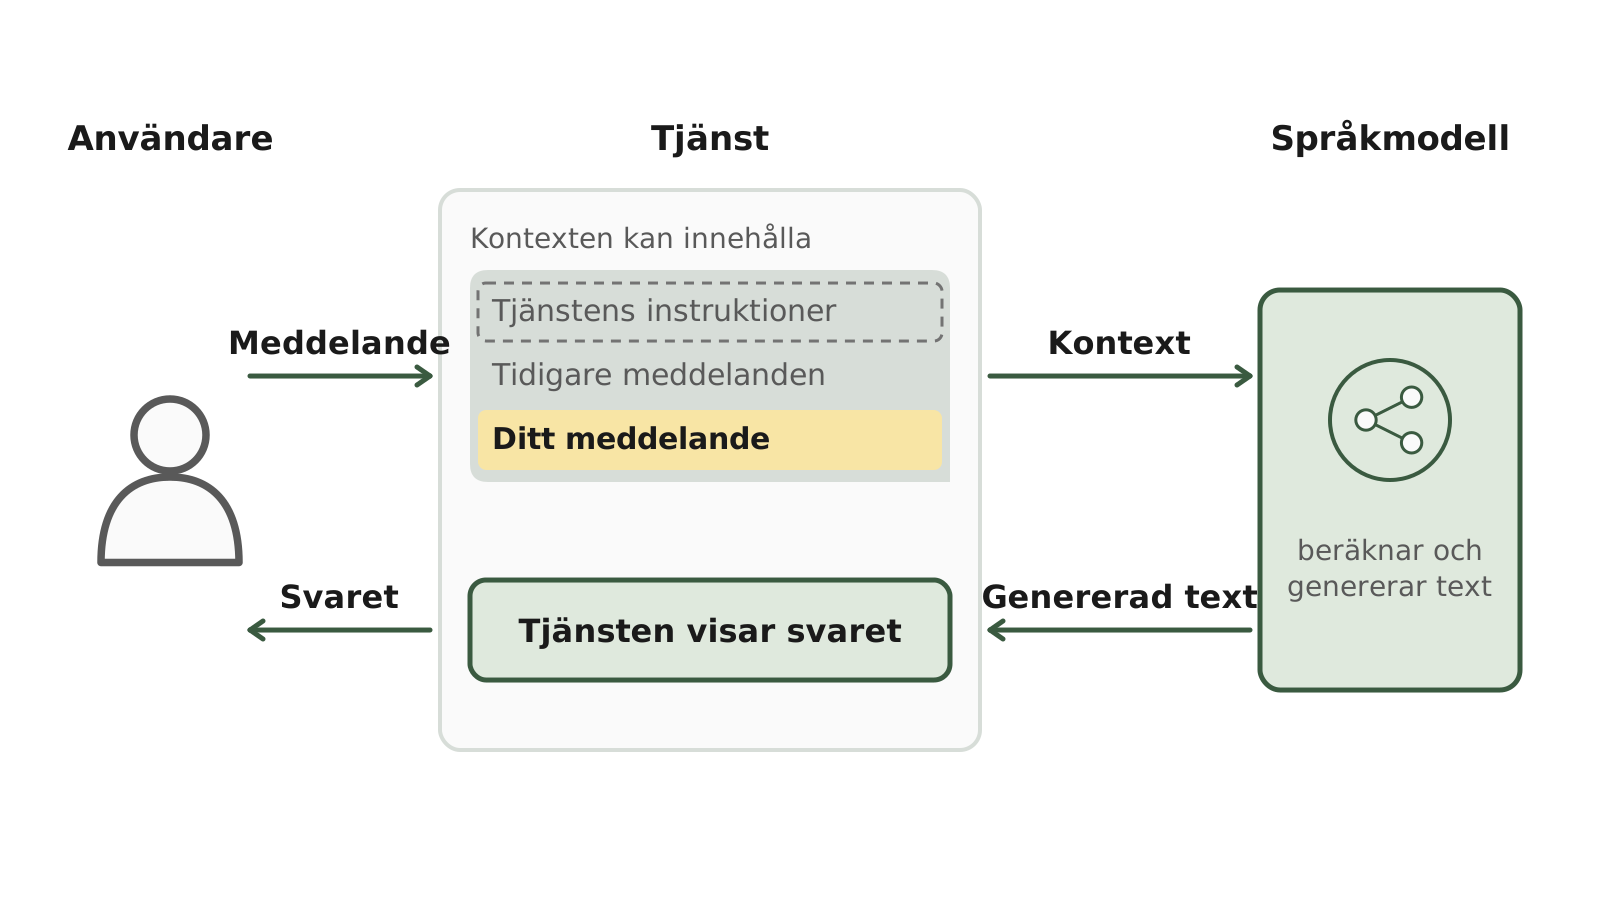
Tjänsten skickar ditt meddelande tillsammans med annan kontext till språkmodellen. Modellen genererar text som tjänsten visar som ett svar.
Modellen är den del som utför beräkningarna och genererar texten. Samma modell kan användas i flera olika tjänster, och en tjänst kan låta användaren välja mellan flera modeller. Därför behöver vi skilja på tjänstens namn och vilken modell som faktiskt används.56
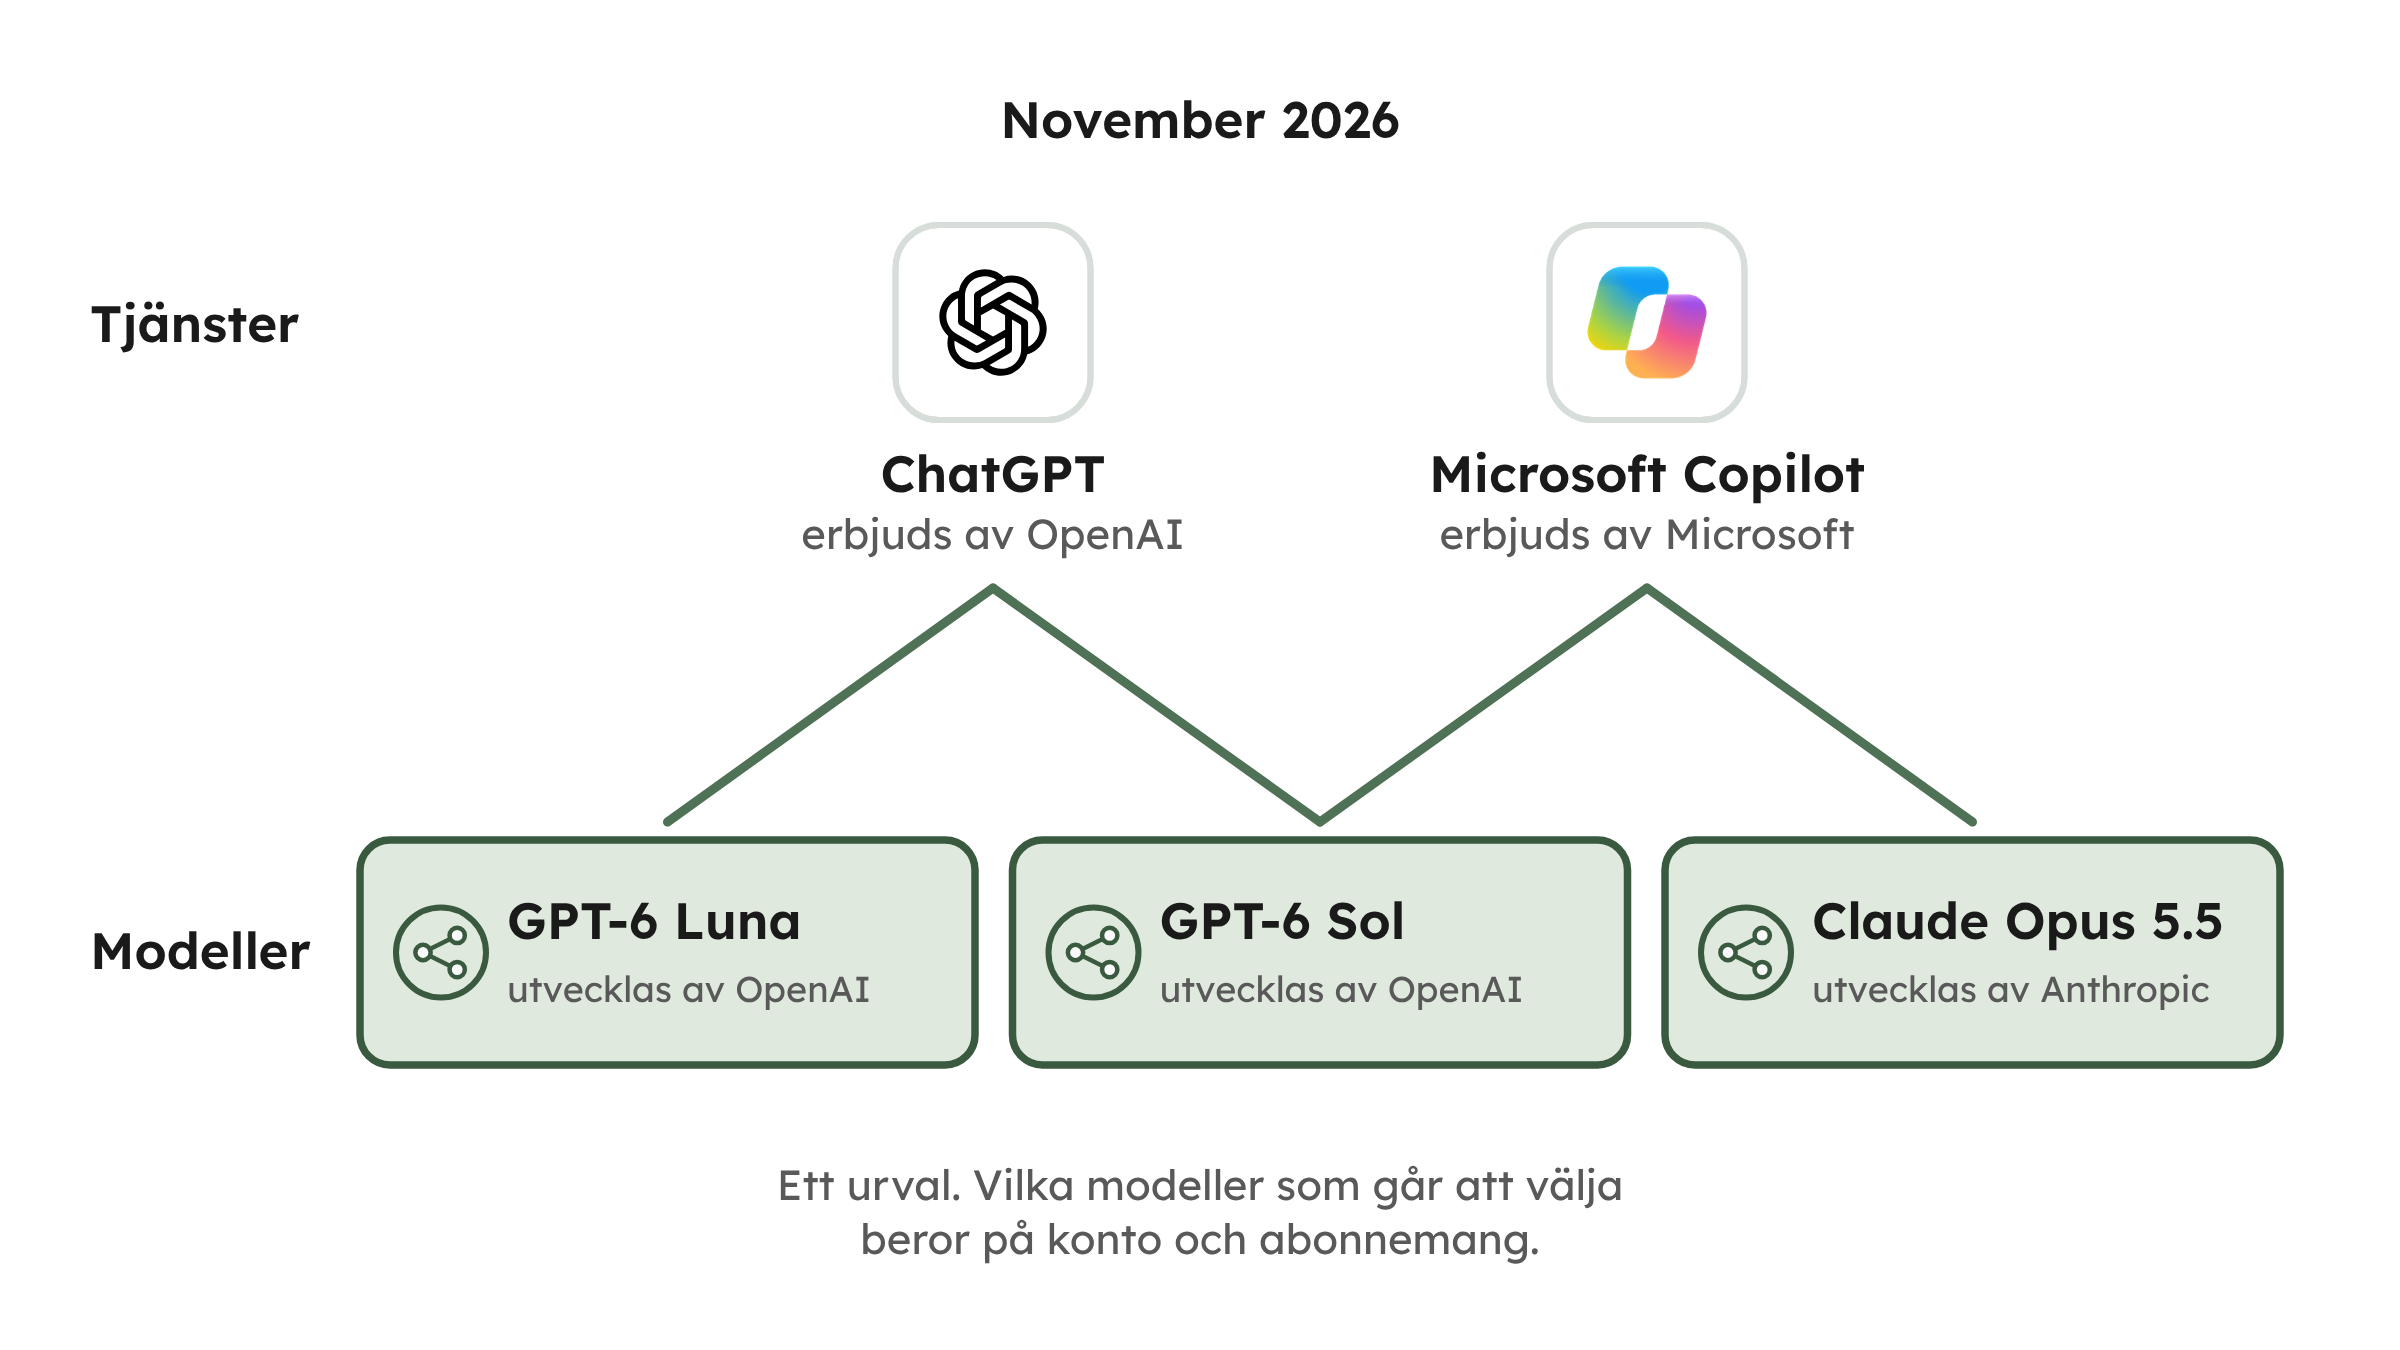
Tjänstens namn och modellens namn är olika saker. En tjänst kan använda flera modeller, och en modell kan användas i flera tjänster. Figuren visar ett urval från november 2026; utbudet förändras snabbt.
Företaget som utvecklar en språkmodell behöver inte vara samma företag som erbjuder tjänsten där du använder den. Dessutom kan ett tredje företag stå för datorerna som kör modellen. Modellutvecklaren, tjänsteleverantören och den som sköter driften kan alltså vara olika aktörer.
När en modell beskrivs som exempelvis amerikansk eller kinesisk syftar det ofta på företaget som har utvecklat den. Det säger inte i sig var dina meddelanden behandlas. För att veta det behöver vi undersöka tjänsten som vi använder.
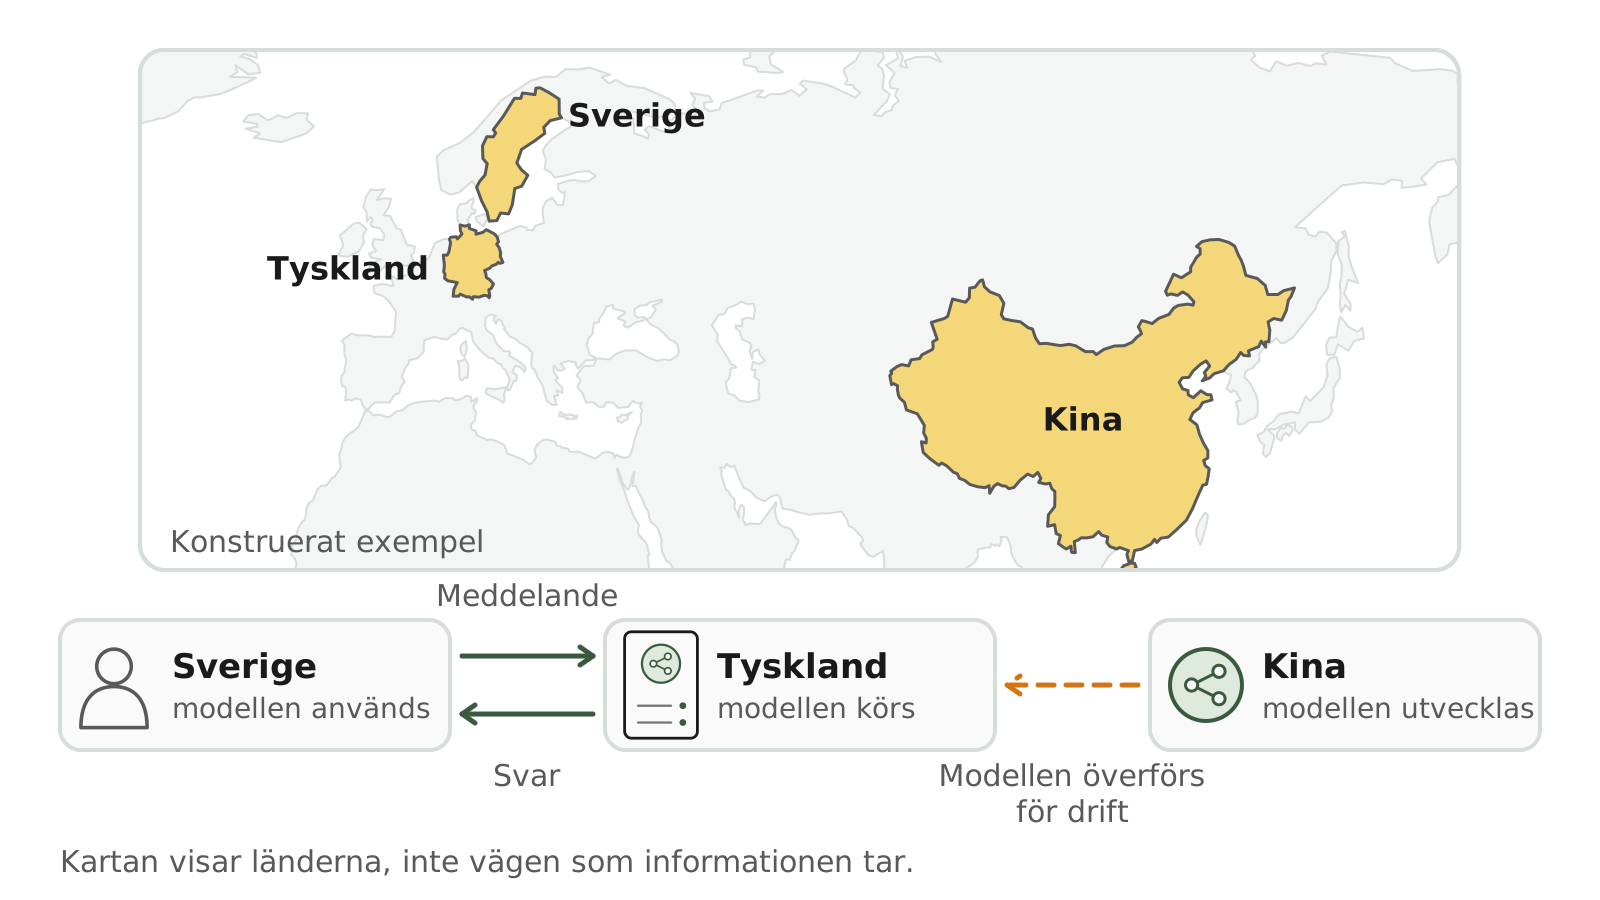
En modell kan utvecklas i ett land, köras i ett annat och användas från ett tredje. I detta konstruerade exempel utvecklas modellen i Kina, körs på en server i Tyskland och används av en person i Sverige.
Hur stor är en språkmodell?
I perceptronen hade varje indata en vikt som påverkade resultatet. En språkmodell innehåller också vikter, men i mycket större antal. Vikterna är exempel på modellens parametrar, de tal som justeras under träningen och sedan används i beräkningarna.
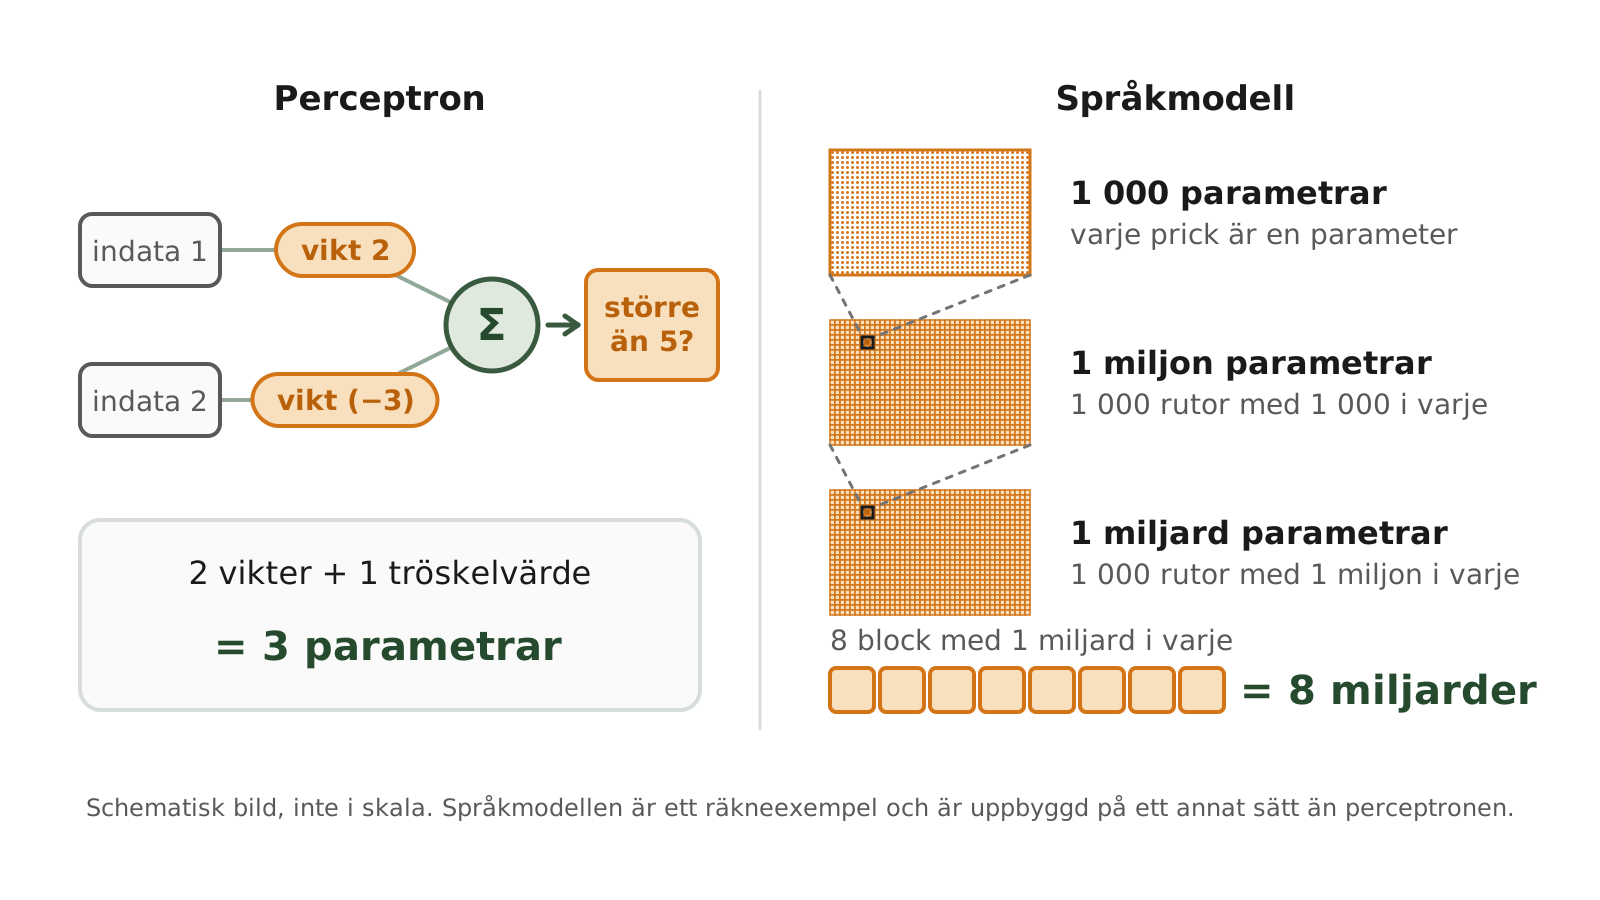
Perceptronen i exemplet har två vikter och ett tröskelvärde. Språkmodellen i jämförelsen har åtta miljarder parametrar. Båda använder tal som bestäms genom träning, men språkmodellen innehåller långt fler och är uppbyggd på ett annat sätt.
Modellens storlek anges ofta som antalet parametrar. Beteckningen 8B betyder exempelvis åtta miljarder parametrar. Bokstaven B kommer från engelskans billion, som betyder miljard. Det beskriver hur många justerbara tal modellen innehåller, inte hur många ord den har tränats på eller hur långt svar den kan skriva.
Antalet parametrar säger däremot inte ensamt hur bra modellen är. Hur den är uppbyggd och vad den har tränats på påverkar också resultatet. För att välja modell behöver vi därför pröva hur väl den klarar just vår uppgift.7
Öppna eller dolda vikter
För vissa språkmodeller går det att ladda ner de färdigtränade vikterna. De brukar kallas modeller med öppna vikter. Med rätt programvara och tillräckligt kraftfull utrustning kan man köra modellen själv. Man kan också använda samma modell genom en tjänst där någon annan sköter driften.8
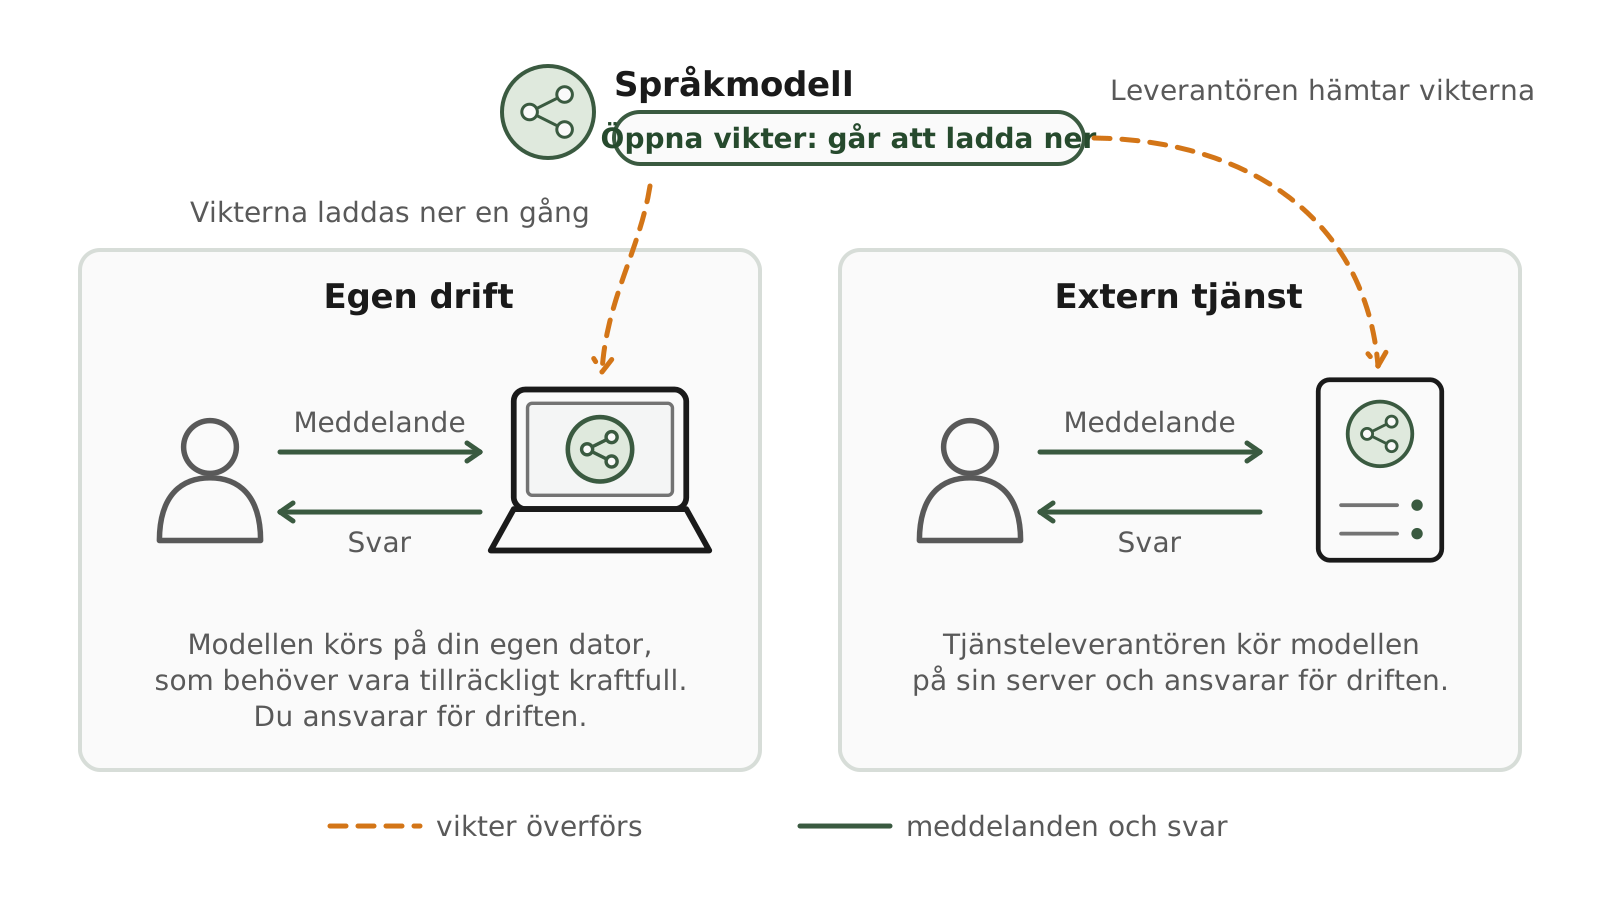
En modell med öppna vikter kan köras på egen utrustning eller användas genom en extern tjänst. Samma modell kan alltså användas på olika sätt, med olika ansvar för driften.
Andra modeller har vikter som inte publiceras. Då kan vi använda modellen genom de tjänster som ger tillgång till den, men inte ladda ner vikterna och köra den själva.
Öppna vikter betyder inte att allt bakom modellen är offentligt. Träningsdatan och koden som användes vid träningen kan fortfarande vara otillgängliga. Det betyder inte heller att modellen får användas hur som helst; villkoren anges i modellens licens.9
Vad kostar det att använda modellen?
Att träna en språkmodell och att använda den är två olika kostnader. Träningen kräver beräkningar för att justera modellens vikter. När den färdigtränade modellen används krävs också beräkningar varje gång den bearbetar indata och genererar ett svar.
Som användare kan du möta kostnaden på olika sätt. En chattjänst kan vara gratis, ha ett abonnemang eller ta betalt efter användning. Att tjänsten är gratis för dig betyder inte att driften saknar kostnader.
När ett program använder en modell hos en leverantör beräknas priset ofta utifrån antalet tokens. Man betalar då för texten som skickas till modellen och texten som modellen genererar. Indata och utdata kan ha olika pris. Tidigare meddelanden som skickas med i kontexten räknas också som indata.10
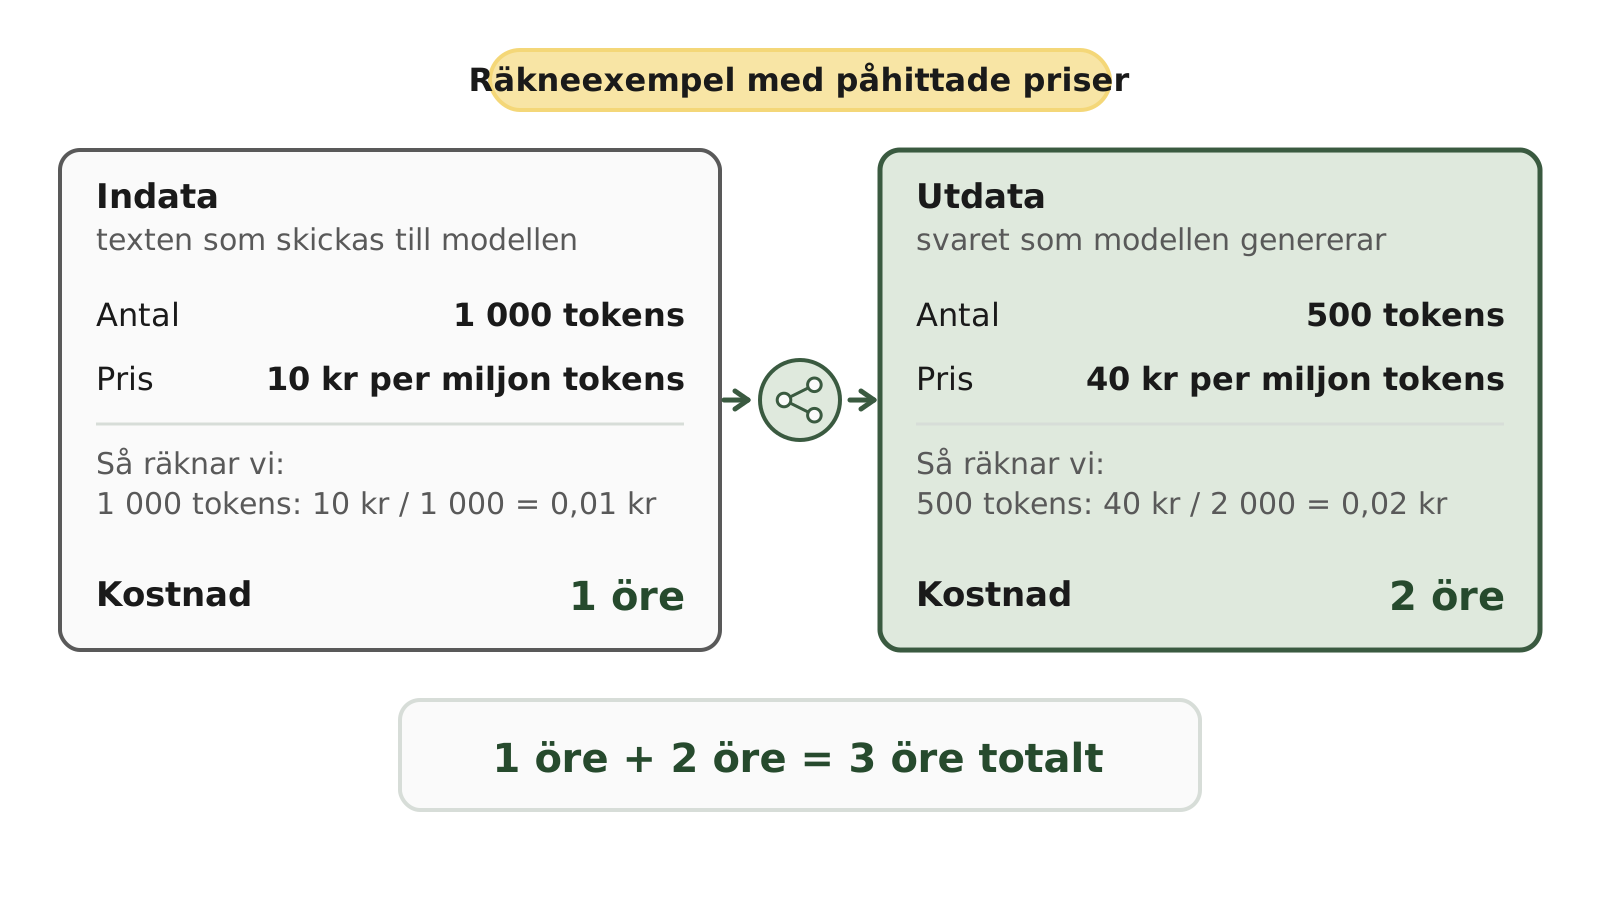
Kostnaden beräknas separat för indata och utdata. Med dessa påhittade priser kostar 1 000 tokens indata och 500 tokens utdata tillsammans 3 öre. Priserna gäller inte någon bestämd modell eller tjänst.
Ett lågt pris betyder inte automatiskt att modellen är ett bra val. Om den missar viktiga fel i rapporten kanske den inte klarar uppgiften. Samtidigt kan en billigare modell vara tillräcklig. Därför behöver vi väga priset mot kvaliteten på svaren.
Hur snabbt svarar modellen?
Språkmodellen genererar svaret en token i taget. Hastigheten brukar anges som antalet tokens per sekund.
Två saker påverkar hastigheten mest: modellens storlek och utrustningen som kör den. Ju fler parametrar modellen har, desto fler beräkningar och mer minne krävs för att generera varje token. En större modell behöver därför kraftfullare utrustning för att nå samma hastighet som en mindre.11
Hastigheten avgör hur länge du får vänta på svaret. Skillnaden märks mest när svaret är långt.
Energi och klimatpåverkan
Både träning och användning av språkmodeller kräver el. Datorerna som utför beräkningarna använder el, och i ett datacenter behövs också energi till bland annat kylning. När många människor använder en modell blir de återkommande beräkningarna en del av dess samlade energianvändning.12
Elanvändning och klimatpåverkan är inte samma sak. Utsläppen beror också på hur elen produceras. Två beräkningar som använder lika mycket el kan därför orsaka olika stora utsläpp beroende på vilken el som försörjer datorerna.13
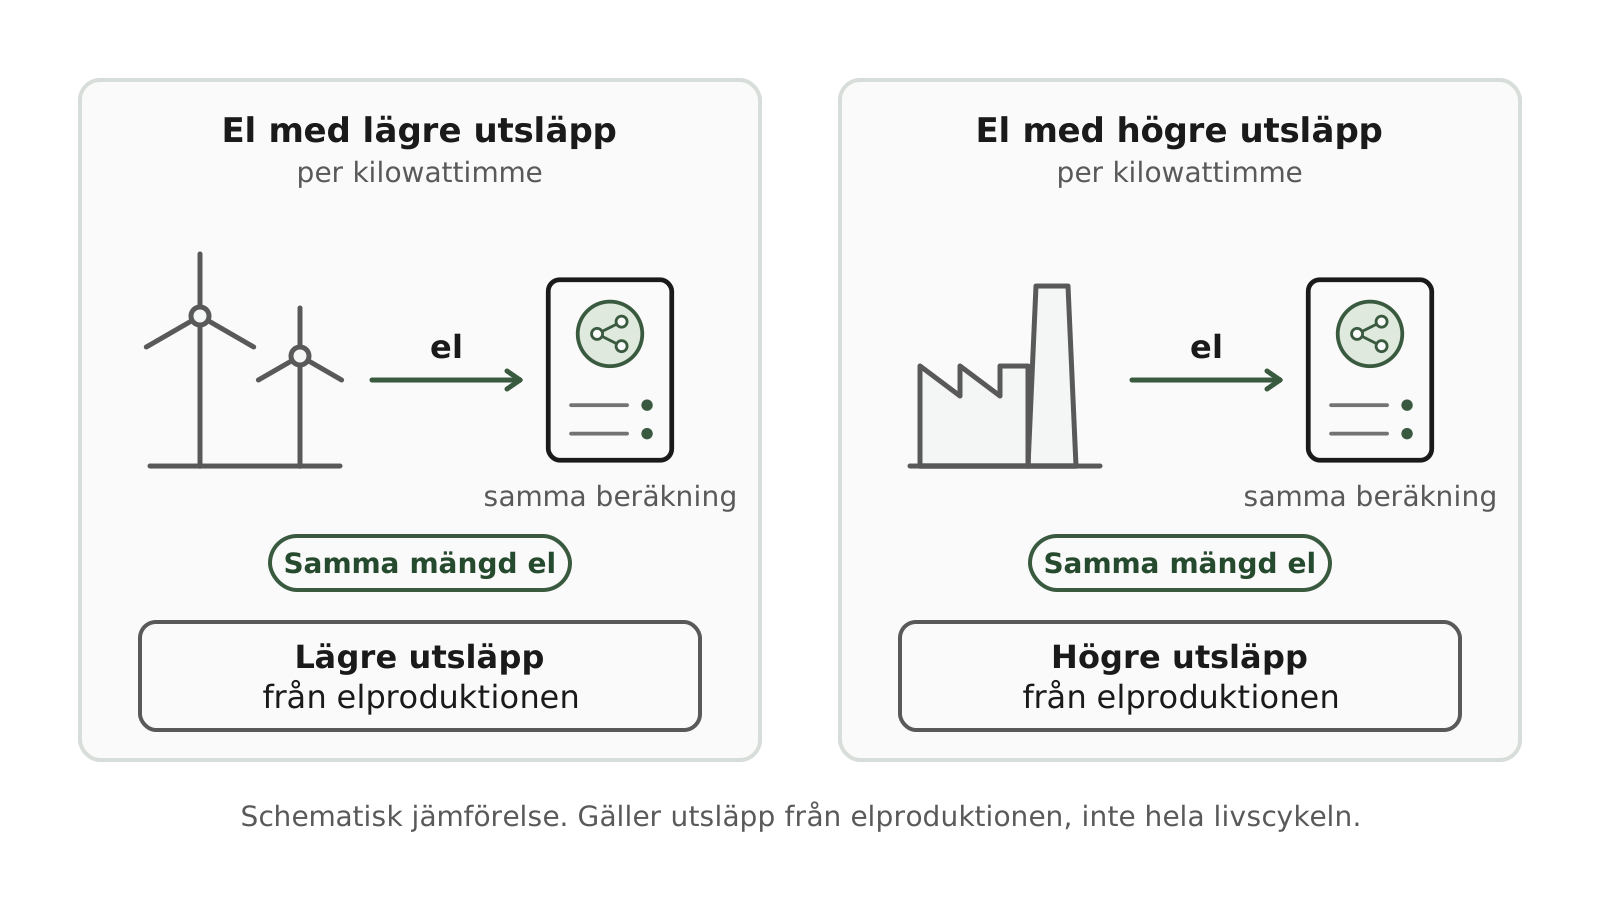
Samma mängd el kan vara förknippad med olika stora utsläpp. Därför behöver vi veta både hur mycket el beräkningarna använder och hur elen produceras.
Det finns inte ett enda energivärde som gäller för ”en fråga till AI”. Energibehovet påverkas av modellen, uppgiften och utrustningen som kör den. Modellens antal parametrar räcker inte för att avgöra energianvändningen. När vi jämför uppskattningar behöver vi därför undersöka vad som har räknats med och under vilka förhållanden.14
Välj modell efter uppgiften
De största modellerna från de ledande utvecklarna är ofta bäst på många olika slags uppgifter. De är också dyrare att använda och kräver kraftfullare utrustning.11 Frågan är därför sällan bara vilken modell som är bäst, utan om en mindre modell är tillräckligt bra för uppgiften.
Börja med kraven. För rapporten behöver modellen hitta motsägelser utan att påstå att korrekta uppgifter är fel. Ge modellerna samma uppgift och samma underlag och kontrollera svaren mot kraven.
Bland modellerna som klarar uppgiften väger du sedan flera saker mot varandra:
- Hastighet och pris. En mindre modell svarar ofta snabbare och kostar mindre.
- Tillgången till vikterna. En modell med öppna vikter kan köras på utrustning som du själv har kontroll över, om utrustningen är tillräckligt kraftfull. En modell med dolda vikter kan bara användas genom de tjänster som ger tillgång till den.
- Ursprunget. Vem som har utvecklat modellen och var tjänsten körs kan spela roll för om du vill använda den.
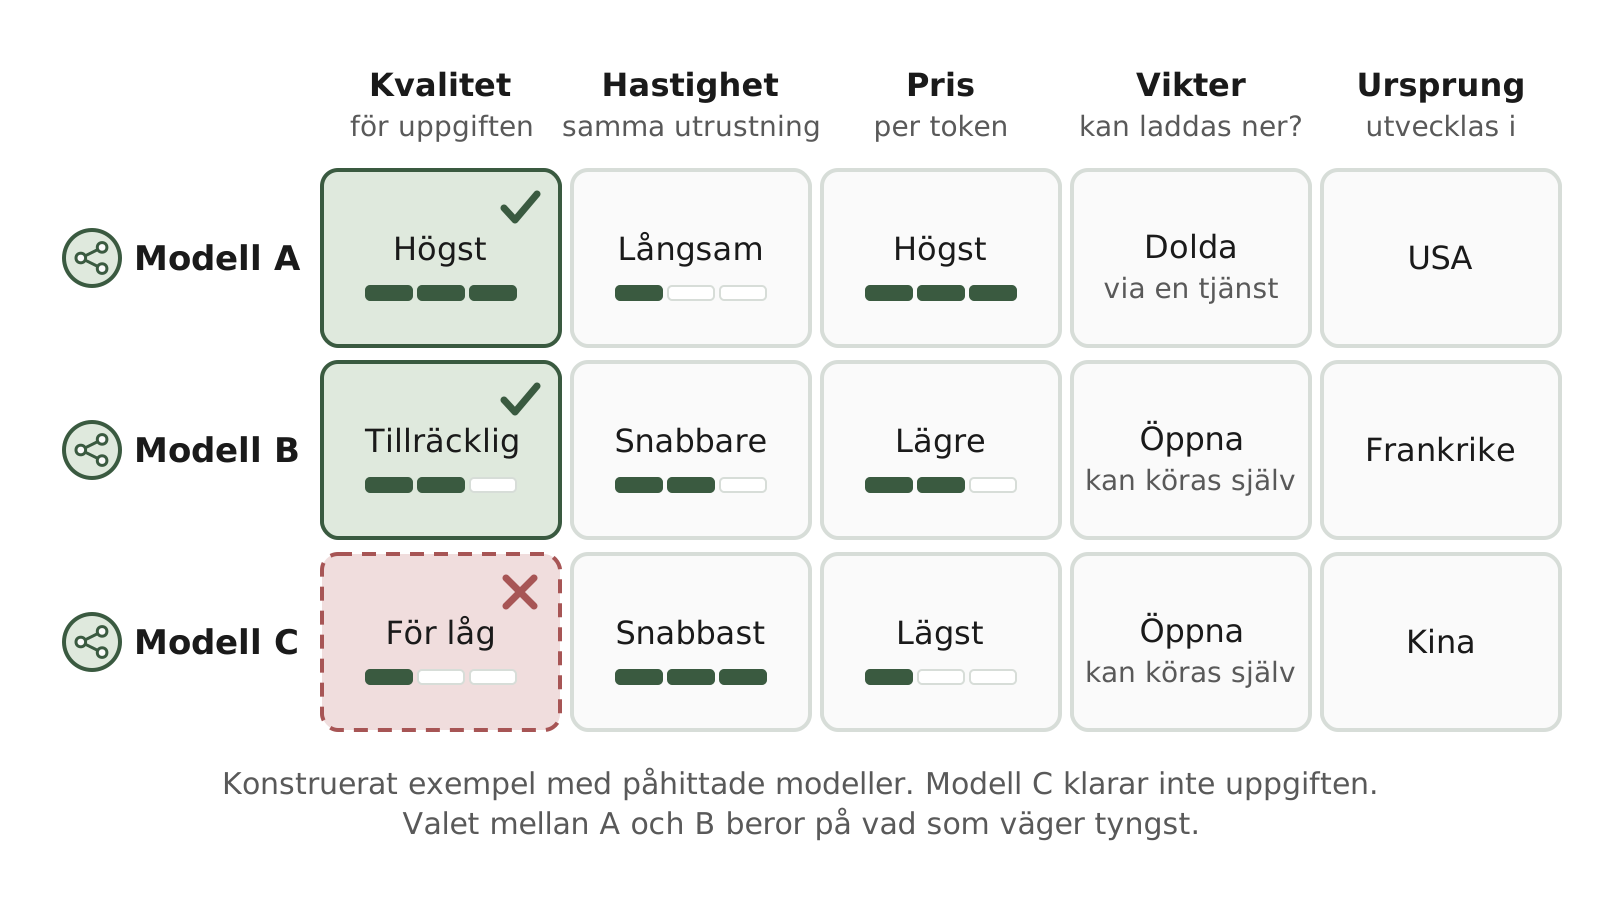
Tre påhittade modeller vägs mot varandra. Modell C klarar inte uppgiften. Valet mellan Modell A och Modell B beror på vad som väger tyngst: kvalitet, hastighet, pris, tillgången till vikterna eller ursprunget.
Slutsatsen gäller det du har undersökt. En modell som räcker för att granska rapporten behöver inte räcka för en svårare uppgift.
Språkmodeller är en del av AI
Stora språkmodeller är en typ av AI-modeller. AI omfattar också andra modeller och metoder, som regression, beslutsträd och sökalgoritmer. Olika tekniker lämpar sig för olika problem. Perceptronen och modellerna för bildigenkänning som vi har arbetat med tidigare i kursen är exempel på AI-modeller som inte är stora språkmodeller.15
Språkmodeller har fått stor uppmärksamhet och spridning sedan ChatGPT lanserades i november 2022.1617 Det betyder inte att all AI bygger på språkmodeller, eller att nästa stora framsteg måste komma från just den tekniken. Det kan också komma från andra metoder eller från nya sätt att kombinera dem.
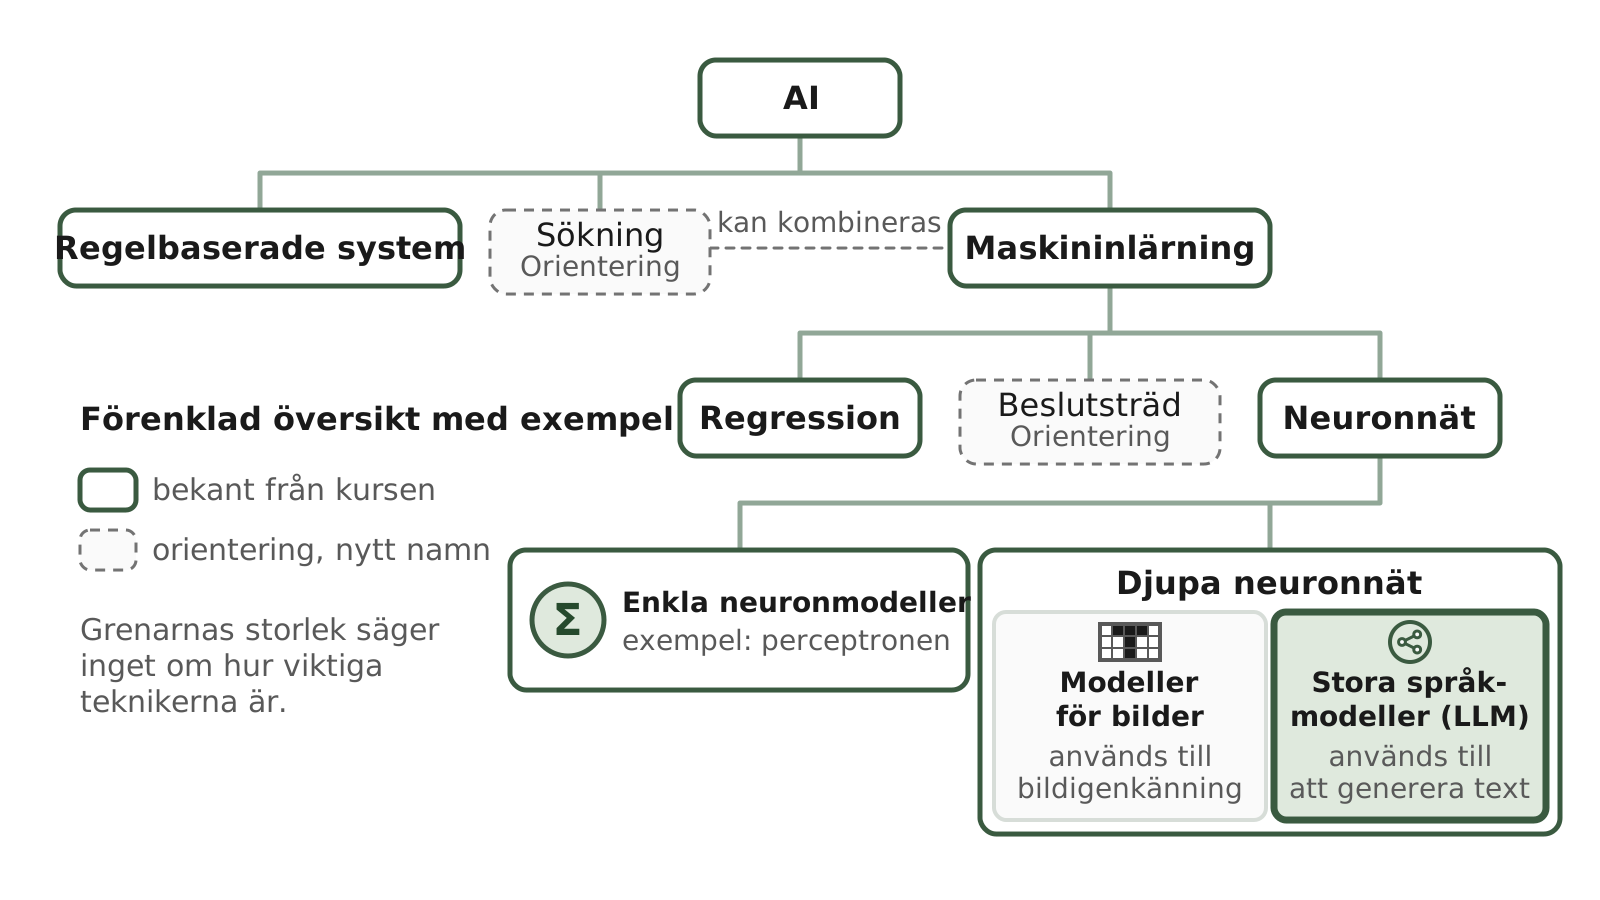
Stora språkmodeller är en av flera typer av AI-modeller. Översikten visar ett urval av metoder och hur de kan hänga ihop. Flera metoder kan kombineras och användas till olika uppgifter.
Sammanfattning
- Tjänsten och modellen är olika saker. En tjänst kan använda flera modeller, och samma modell kan användas i flera tjänster.
- Utveckling, drift och användning kan ske i olika länder. Modellens ursprung säger inte ensamt var dina meddelanden behandlas.
- Parametrar är tal som justeras under träningen. Fler parametrar betyder inte automatiskt bättre resultat på en viss uppgift.
- Öppna vikter kan laddas ner, men egen drift kräver rätt utrustning och programvara. Träningsdata och träningskod behöver inte vara offentliga.
- Både träning och användning kräver resurser. Användarens pris, elanvändningen och klimatpåverkan är olika saker.
- Hastigheten anges i tokens per sekund. En större modell behöver kraftfullare utrustning för att nå samma hastighet som en mindre.
- Välj modell efter uppgiften. Kontrollera att modellen klarar kraven och väg sedan hastighet, pris, tillgången till vikterna och ursprunget mot varandra.
- Stora språkmodeller är en del av AI. Andra modeller och metoder kan passa bättre för andra problem.
Källor och vidare läsning
För dig som vill läsa mer. Texterna är på engelska; läroböckerna och forskningsartikeln är främst för fördjupning och lärarbakgrund.
- AI:s bredd: Stuart Russell och Peter Norvig, Artificial Intelligence: A Modern Approach, fjärde upplagan. Författarnas boköversikt visar bland annat sökning, maskininlärning, neuronnät och datorseende.
- Språkmodeller: Daniel Jurafsky och James H. Martin, Speech and Language Processing, tredje upplagans nätutkast, 19 augusti 2026. Börja med introduktionskapitlet i den fritt tillgängliga läroboken.
- Energi och klimat: IEA, Energy and AI, 2025. Rapporten ger en samlad bild av datacenter, elanvändning och klimatpåverkan.
- Forskning om energibehov: Alexandra Sasha Luccioni, Yacine Jernite och Emma Strubell, Power Hungry Processing: Watts Driving the Cost of AI Deployment?, 2024. Studien jämför energianvändning för olika modeller och uppgifter.
- Öppna vikter: Open Source Initiative, Open Weights: not quite what you’ve been told. Organisationens förklaring av skillnaden mellan öppna vikter och öppen källkod för AI.
Produktdokumentation och övriga underlag för enskilda påståenden finns i fotnoterna.
Fotnoter
-
Google, Just ask anything: a seamless new Search experience, 27 januari 2026, originalinlägget. Om Gemini-modeller i AI-funktioner i Google Sök. ↩
-
Moonshot AI, Kimi Overview. Om Kimi och utvecklaren Moonshot AI. ↩
-
Mistral AI, Le Chat is now Vibe, 12 augusti 2026, namnbytet. ↩
-
Grok, grok.com, kontrollerad 15 november 2026. Tjänsten anger att Grok är byggd av SpaceXSI; företaget hette tidigare xAI. ↩
-
OpenAI, ChatGPT release notes, post om GPT-6 från 7 oktober 2026, kontrollerad 15 november 2026. Om GPT-6 Sol och GPT-6 Luna i ChatGPT. ↩
-
Microsoft, More Models, One Copilot, 22 september 2026, blogginlägget. Om GPT-6 Sol och Claude Opus 5.5 i Microsoft Copilot. ↩
-
Hugo Touvron med flera, LLaMA: Open and Efficient Foundation Language Models, 2023, originalartikeln. Skiljer parameterantal från mängden träningstext och jämför olika modellstorlekar. ↩
-
Google, Gemma models overview, kontrollerad 15 november 2026. Exempel på modeller som kan köras på egen utrustning eller genom en värdtjänst. ↩
-
Open Source Initiative, Open Weights: not quite what you’ve been told, kontrollerad 15 november 2026. Om tillgång till vikter, träningskod och information om träningsdata. ↩
-
Anthropic, Pricing och Context windows, kontrollerade 15 november 2026. Om tokenprissättning och samtalshistorik som indata. Räkneexemplets priser är påhittade. ↩
-
Google, Gemma 4 model overview, avsnittet Parameter sizes and quantization, kontrollerad 16 november 2026. Om att modeller med fler parametrar oftast är mer kapabla men kräver mer beräkningar, minne och energi. ↩ ↩2
-
IEA, Energy and AI, 2025, Energy demand from AI. Om datacentrens utrustning och elanvändning, inklusive servrar och kylning. ↩
-
IEA, Energy and AI, 2025, AI and climate change. Om utsläpp från elproduktionen som försörjer datacenter. ↩
-
Alexandra Sasha Luccioni, Yacine Jernite och Emma Strubell, Power Hungry Processing: Watts Driving the Cost of AI Deployment?, ACM FAccT 2024, originalartikeln. Mätvärdena gäller studiens undersökta modeller och försöksförhållanden. ↩
-
Stuart Russell och Peter Norvig, Artificial Intelligence: A Modern Approach, fjärde upplagan, författarnas innehållsöversikt. Lektionens teknikträd är en förenklad översikt. ↩
-
OpenAI, Introducing ChatGPT, 30 november 2022, lanseringsinlägget. ↩
-
OpenAI, How people are using ChatGPT, 15 september 2025, studiepresentationen. Om ChatGPT:s växande användning efter lanseringen. ↩